Která AI staví nejlépe?
Osm modelů dostane stejné zadání a 150 obdélníků. Každý má jeden pokus a podle shody s přesnou předlohou získá 0 až 100 bodů. Každý týden probíhá nové kolo.
Week 2026-W47, Nov 16 to 19
Tento týden
Week 2026-W47, Nov 16 to 19
Změna oproti minulému týdnu.
Co jednotlivé modely vytvořily
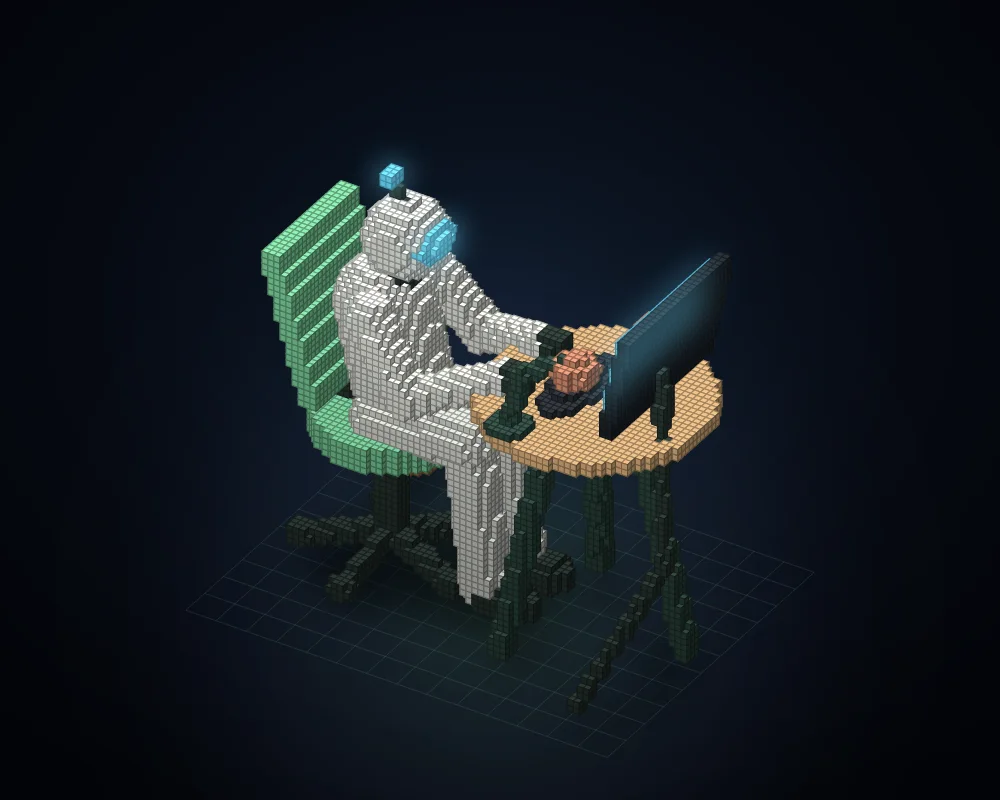
Výstup bez úprav, vykreslený z JSONu, který model vrátil. Čárkovaný obrys vyznačuje předlohu.


Poznámky
Zhoršil se model?
Zadání je každý týden stejné, takže náhlý pokles skóre stojí za pozornost. Výsledek každého kola porovnáváme s průměrem téhož modelu ze čtyř předchozích kol.
Co bylo potřeba k dosažení jednotlivých výsledků?
Součet vstupních a výstupních tokenů a doba běhu za stejný týden. U modelů na čárkované čáře žádný jiný model současně nedosáhl vyššího skóre a nižších nákladů.
Week 2026-W47
Zobrazit měření tokenů a doby běhu
Proč se liší počty vstupních tokenů? Všechny modely dostávají stejné testovací zadání, ale poskytovatelé uvádějí počty za celý běh CLI včetně vestavěných instrukcí. Modely mohou stejný text rozdělit na tokeny různě a navazující požadavky mohou stejný kontext započítat znovu. Celkový počet vstupních tokenů u Claude zahrnuje tokeny mimo mezipaměť i jejich čtení z mezipaměti a zápis do ní. Tokeny použité k uvažování započítáváme podle údajů poskytovatele. Chybějící hodnoty necháváme prázdné. Uvedené počty nevyjadřují cenu.
Vývoj mezi koly
Úvodní kolo si zachovává původní výsledky. Každý další bod představuje nové kolo s výsledky naměřenými v daném týdnu.
Zobrazit zaznamenaná skóre
Výchozí měření zachovává původní výsledky prvního kola i data měření.
| Kolo | Claude Opus 5 / Claude Opus 5.5 | Claude Sonnet 5 / Claude Sonnet 5.5 | Claude Fable 5.1 / Claude Fable 5.2 | GPT-6.1 Sol / GPT-6.2 Sol | GPT-6 Astra / GPT-6.2 Astra | GPT-6 Luna | GPT-6.1 Terra | Claude Haiku 5.5 |
|---|---|---|---|---|---|---|---|---|
| 2026-W47 | 74.7 (Claude Opus 5.5) | 60.8 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 84.6 (GPT-6.2 Sol) | 78.5 (GPT-6.2 Astra) | 34.9 (GPT-6 Luna) | 70.7 (GPT-6.1 Terra) | 72.6 (Claude Haiku 5.5) |
| 2026-W46 | 74.8 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 72.5 (GPT-6.1 Sol) | 79.1 (GPT-6 Astra) | 38.8 (GPT-6 Luna) | 70.3 (GPT-6.1 Terra) | 65.3 (Claude Haiku 5.5) |
| 2026-W45 | 80.1 (Claude Opus 5.5) | 56.7 (Claude Sonnet 5.5) | 77.8 (Claude Fable 5.1) | 76.4 (GPT-6.1 Sol) | 78 (GPT-6 Astra) | 41.8 (GPT-6 Luna) | 71.3 (GPT-6.1 Terra) | 66 (Claude Haiku 5.5) |
| 2026-W44 | 74.4 (Claude Opus 5.5) | 64.9 (Claude Sonnet 5.5) | 76.9 (Claude Fable 5.1) | 81.4 (GPT-6.1 Sol) | 77.7 (GPT-6 Astra) | 46.7 (GPT-6 Luna) | 73.1 (GPT-6.1 Terra) | 73.2 (Claude Haiku 5.5) |
| 2026-W43 | 75.9 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 75.7 (Claude Fable 5.1) | 72.5 (GPT-6.1 Sol) | 79.7 (GPT-6 Astra) | 33.9 (GPT-6 Luna) | - | 73.6 (Claude Haiku 5.5) |
| 2026-W42 | 75.1 (Claude Opus 5.5) | 67.4 (Claude Sonnet 5.5) | 69 (Claude Fable 5.1) | 77.9 (GPT-6.1 Sol) | 78.4 (GPT-6 Astra) | 43.7 (GPT-6 Luna) | - | 65.7 (Claude Haiku 5.5) |
| 2026-W41 | 78.5 (Claude Opus 5.5) | 48.1 (Claude Sonnet 5.5) | 74.6 (Claude Fable 5.1) | 74.7 (GPT-6.1 Sol) | 73.5 (GPT-6 Astra) | 30.9 (GPT-6 Luna) | - | 68.4 (Claude Haiku 5.5) |
| Výchozí stav | 75.5 (Claude Opus 5) | 34.3 (Claude Sonnet 5) | 71.2 (Claude Fable 5.1) | 70.6 (GPT-6.1 Sol) | 77.5 (GPT-6 Astra) | 45.6 (GPT-6 Luna) | - | - |
Every weekly run
Generated from the same records as the chart. Each week has its own address, for example https://vibeide.dev/benchmark/#2026-w47. Download every run as CSV.
| Week | Run date | Model | Score | Change vs previous round |
|---|---|---|---|---|
| 2026-W47 | GPT-6.2 Sol | 84.6 | New model version | |
| 2026-W47 | Claude Fable 5.2 | 79.3 | 0.0 | |
| 2026-W47 | GPT-6.2 Astra | 78.5 | New model version | |
| 2026-W47 | Claude Opus 5.5 | 74.7 | -0.1 | |
| 2026-W47 | Claude Haiku 5.5 | 72.6 | +7.3 | |
| 2026-W47 | GPT-6.1 Terra | 70.7 | +0.4 | |
| 2026-W47 | Claude Sonnet 5.5 | 60.8 | -0.2 | |
| 2026-W47 | GPT-6 Luna | 34.9 | -3.9 | |
| 2026-W46 | Claude Fable 5.2 | 79.3 | New model version | |
| 2026-W46 | GPT-6 Astra | 79.1 | +1.1 | |
| 2026-W46 | Claude Opus 5.5 | 74.8 | -5.3 | |
| 2026-W46 | GPT-6.1 Sol | 72.5 | -3.9 | |
| 2026-W46 | GPT-6.1 Terra | 70.3 | -1.0 | |
| 2026-W46 | Claude Haiku 5.5 | 65.3 | -0.7 | |
| 2026-W46 | Claude Sonnet 5.5 | 61 | +4.3 | |
| 2026-W46 | GPT-6 Luna | 38.8 | -3.0 | |
| 2026-W45 | Claude Opus 5.5 | 80.1 | +5.7 | |
| 2026-W45 | GPT-6 Astra | 78 | +0.3 | |
| 2026-W45 | Claude Fable 5.1 | 77.8 | +0.9 | |
| 2026-W45 | GPT-6.1 Sol | 76.4 | -5.0 | |
| 2026-W45 | GPT-6.1 Terra | 71.3 | -1.8 | |
| 2026-W45 | Claude Haiku 5.5 | 66 | -7.2 | |
| 2026-W45 | Claude Sonnet 5.5 | 56.7 | -8.2 | |
| 2026-W45 | GPT-6 Luna | 41.8 | -4.9 | |
| 2026-W44 | GPT-6.1 Sol | 81.4 | +8.9 | |
| 2026-W44 | GPT-6 Astra | 77.7 | -2.0 | |
| 2026-W44 | Claude Fable 5.1 | 76.9 | +1.2 | |
| 2026-W44 | Claude Opus 5.5 | 74.4 | -1.5 | |
| 2026-W44 | Claude Haiku 5.5 | 73.2 | -0.4 | |
| 2026-W44 | GPT-6.1 Terra | 73.1 | First run | |
| 2026-W44 | Claude Sonnet 5.5 | 64.9 | +3.9 | |
| 2026-W44 | GPT-6 Luna | 46.7 | +12.8 | |
| 2026-W43 | GPT-6 Astra | 79.7 | +1.3 | |
| 2026-W43 | Claude Opus 5.5 | 75.9 | +0.8 | |
| 2026-W43 | Claude Fable 5.1 | 75.7 | +6.7 | |
| 2026-W43 | Claude Haiku 5.5 | 73.6 | +7.9 | |
| 2026-W43 | GPT-6.1 Sol | 72.5 | -5.4 | |
| 2026-W43 | Claude Sonnet 5.5 | 61 | -6.4 | |
| 2026-W43 | GPT-6 Luna | 33.9 | -9.8 | |
| 2026-W42 | GPT-6 Astra | 78.4 | +4.9 | |
| 2026-W42 | GPT-6.1 Sol | 77.9 | +3.2 | |
| 2026-W42 | Claude Opus 5.5 | 75.1 | -3.4 | |
| 2026-W42 | Claude Fable 5.1 | 69 | -5.6 | |
| 2026-W42 | Claude Sonnet 5.5 | 67.4 | +19.3 | |
| 2026-W42 | Claude Haiku 5.5 | 65.7 | -2.7 | |
| 2026-W42 | GPT-6 Luna | 43.7 | +12.8 | |
| 2026-W41 | Claude Opus 5.5 | 78.5 | New model version | |
| 2026-W41 | GPT-6.1 Sol | 74.7 | +4.1 | |
| 2026-W41 | Claude Fable 5.1 | 74.6 | +3.4 | |
| 2026-W41 | GPT-6 Astra | 73.5 | -4.0 | |
| 2026-W41 | Claude Haiku 5.5 | 68.4 | First run | |
| 2026-W41 | Claude Sonnet 5.5 | 48.1 | New model version | |
| 2026-W41 | GPT-6 Luna | 30.9 | -14.7 | |
| 2026-W41 (Starting baseline) | GPT-6 Astra | 77.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Opus 5 | 75.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Fable 5.1 | 71.2 | First run | |
| 2026-W41 (Starting baseline) | GPT-6.1 Sol | 70.6 | First run | |
| 2026-W41 (Starting baseline) | GPT-6 Luna | 45.6 | First run | |
| 2026-W41 (Starting baseline) | Claude Sonnet 5 | 34.3 | First run |
Jak to funguje
Jedno zadání
Zadání uvádí každý tvar předlohy s přesnými číselnými hodnotami.
Jeden pokus
Každý model odpoví jednou ve formátu JSON. Bez nápovědy a bez výběru nejlepšího z N pokusů.
Jedno skóre
Shoda tvarů a barev s předlohou na stupnici od 0 do 100.
Úplná metodika, dotazy a citace
Last updated
Vzorec
objemový překryv v % × podíl správně obarvených krychlíMěřeno v jednotkách o objemu 1 cm³. Otisk zadání 08fb5a5773fe89e7. Výchozí referenční hodnoty zachovávají původní výsledky prvního kola.
Jak to funguje
Zadání uvádí všechny tvary předlohy s přesnými číselnými údaji. Každý model odpovídá pouze ve formátu JSON: nejvýše 150 kvádrů, u každého poloha, velikost a jedna z 11 barev. Model sám nic nekreslí. Při hodnocení výstupu vykreslíme jeho kvádry i předlohu ze stejných malých krychlí, se stejným osvětlením a kamerou, a obrázky zveřejníme.
Skóre se počítá jako objemový překryv sochy a předlohy (poměr průniku ke sjednocení, měřený v krychlích o hraně 1 cm) vynásobený podílem společných krychlí se správnou barvou. Použití jednoho kvádru na každý tvar přináší méně než 40 bodů; rozdělení každého tvaru na stejně silné vrstvy přináší přibližně 50 bodů. Nakloněné nohy, tenké kabely a kulaté hlavy zvýhodňují modely, které plánují umístění každého kvádru. Zobrazení Rozdíly ukazuje každou chybějící krychli, krychli navíc i krychli s nesprávnou barvou.
Férové a opakovatelné
Výchozí stav představuje původní první kolo, zachované se skutečnými daty měření. Pro spuštění bylo vyžádáno druhé měřené kolo. Zobrazují se obě kola; ani jedno nemá zpětně upravené datum a nebylo vybráno jako lepší ze dvou výsledků. Další kola probíhají podle týdenního harmonogramu.
- Každý týden stejné zadání, stejný hodnoticí program a stejné nastavení. Zadání v3 má otisk
08fb5a5773fe89e7; jakákoli změna zahajuje novou verzi a nový graf. - Každý model odpovídá jednou se střední úrovní uvažování prostřednictvím Claude Code nebo Codex s přihlášením přes předplatné, tedy stejně, jako je spouští VibeiDE. Bez nástrojů, bez webu a bez výběru nejlepšího z N pokusů.
- Odpověď, v níž nelze vyhodnotit ani jeden box (není ve formátu JSON nebo mají všechny boxy chybnou strukturu), je chybou formátu, nikoli sochou: model dostane ještě jeden pokus a za tuto odpověď se odečtou 2 body.
- Modely běží postupně, nikdy souběžně. Pokud odpověď nedorazí do 40 minut, získá skóre 0.
- Hodnoticí program je deterministický. Žádný model nehodnotí jiný model.
Přečíst úplné zadání (prostý text, 7,691 znaků). Názvy modelů jsou aliasy nabízené jednotlivými CLI; stránka zaznamenává identifikátor modelu, který CLI nahlásilo.
Otázky
Zhoršuje se výkon modelů Claude nebo GPT?
Tato stránka nevidí do interního fungování poskytovatele, ale ukazuje, zda model se stejným názvem získává v průběhu času jiné skóre za stejné neměnné zadání. Jeden běh týdně představuje jediný vzorek, takže posun o několik bodů berte jako šum a pokles trvající několik týdnů jako signál.
Proč žádný model nemůže dosáhnout 100 bodů?
Předloha se skládá z koulí, elipsoidů, válců a nakloněných kapslí, ale odpověď smí použít pouze 150 kvádrů zarovnaných se souřadnicovými osami. Kvádrům se nikdy nepodaří přesně kopírovat křivky, takže každá odpověď část objemu ztrácí. Lepší modely využívají kvádry tam, kde jsou zakřivené tvary, a jejich sochy se více podobají předloze.
Jak modely spouštíte?
Každý model dostane zadání jednou prostřednictvím svého oficiálního nástroje příkazového řádku, Claude Code nebo Codex, s přihlášením přes běžné předplatné a se střední úrovní uvažování. Nástroje, dílčí agenti a přístup k webu jsou vypnuté; pokud model přesto při běhu použije nástroj, přijde o čtvrtinu skóre. Opakovaný pokus dostane pouze model, v jehož odpovědi nelze vyhodnotit ani jeden box, a to jen jednou. Za tuto odpověď se odečtou 2 body. Odpověď hodnotí deterministický program, nikoli jiný model.
Proč benchmark přešel na v3?
První dvě verze žádaly modely o rozmístění kanceláře. V prvních kolech získaly nejlepší modely 100 a 92 bodů a všechny správně uspořádané kanceláře vypadaly stejně. Benchmark, v němž špičkové modely dosahují maxima, nedokáže ukázat vývoj, a benchmark s podobně vypadajícími odpověďmi nedokáže ukázat kvalitu. Proto v3 žádá o sochu, jejíž kvalita je patrná na první pohled.
Mohu si zadání vyzkoušet?
Ano. Úplné zadání je veřejně dostupné jako prostý text. Vložte ho do libovolného modelu a porovnejte jeho odpověď s předlohou.
Cite this benchmark
- Title
- VibeiDE Robot scene v1: weekly Claude and GPT model tracking
- URL
https://vibeide.dev/benchmark/- Latest week
- 2026-W47, run
- Publisher
- Crowie s.r.o.
- Method
- Each model answers the same frozen brief once at medium reasoning effort, with no tools. A reply with no usable boxes is asked once more, with a 2-point penalty. Volume overlap against the target, weighted by color accuracy, from 0 to 100.
- Licence
- Benchmark data and charts are licensed under CC BY 4.0. Please credit 'VibeiDE benchmark' with a link to https://vibeide.dev/benchmark/.
Suggested citationCrowie s.r.o. (2026). VibeiDE Robot scene v1: weekly Claude and GPT model tracking, week 2026-W47. https://vibeide.dev/benchmark/#2026-w47