Quelle IA construit le mieux ?
Huit modèles reçoivent les mêmes consignes et 150 rectangles. Chacun a un seul essai, noté de 0 à 100 selon sa fidélité à la cible exacte. Une nouvelle manche chaque semaine.
Week 2026-W47, Nov 16 to 19
Cette semaine
Week 2026-W47, Nov 16 to 19
Écart par rapport à la semaine dernière.
Ce que chaque modèle a créé
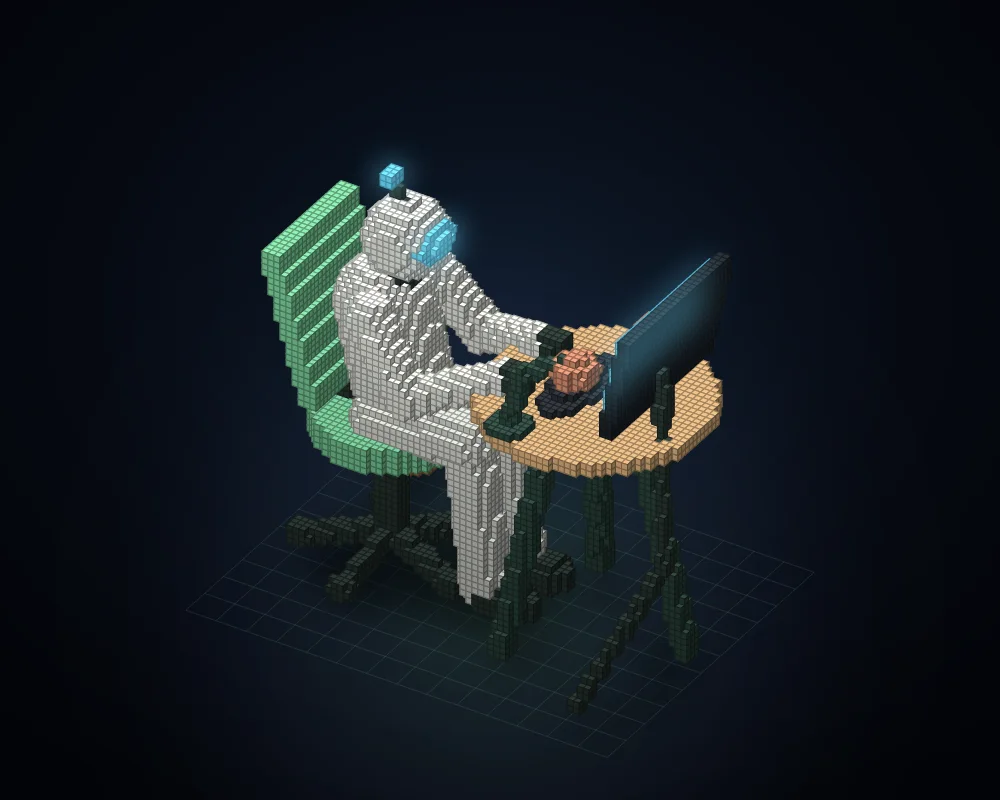
Résultat brut affiché à partir du JSON renvoyé par chaque modèle. Le contour en pointillés représente la cible.


Notes
Le modèle a-t-il été bridé ?
Les consignes sont les mêmes chaque semaine. Si le score d’un modèle chute soudainement, cela mérite qu’on s’y attarde. À chaque manche, nous comparons le score du modèle à sa propre moyenne sur les quatre manches précédentes.
Quelles ressources chaque résultat a-t-il nécessitées ?
Total des tokens d’entrée et de sortie, et temps écoulé, pour la même semaine. Aucun autre modèle ne fait mieux à la fois sur le score et sur le coût que les modèles situés sur la ligne en pointillés.
Week 2026-W47
Consultez les mesures de tokens et de durée d’exécution
Pourquoi le nombre de tokens d’entrée varie-t-il ? Tous les modèles reçoivent les mêmes consignes pour le test, mais les décomptes sont ceux que les fournisseurs indiquent pour l’exécution complète du CLI, y compris les instructions intégrées. Les modèles peuvent découper le même texte en tokens de différentes manières, et les requêtes qui poursuivent un échange peuvent comptabiliser de nouveau le contexte. Le total de tokens d’entrée de Claude comprend les tokens hors cache, ainsi que les lectures et les écritures dans le cache. Les tokens de raisonnement sont comptabilisés uniquement selon les chiffres communiqués par le fournisseur. Les valeurs manquantes sont laissées vides. Les décomptes indiqués ne mesurent pas les prix.
D’une manche à l’autre
La première manche conserve ses résultats d’origine. Chaque point suivant correspond à une nouvelle manche, mesurée la semaine où elle a lieu.
Consultez les scores enregistrés
La référence de départ conserve les résultats d’origine de la première manche et leurs dates de mesure.
| Cycle | Claude Opus 5 / Claude Opus 5.5 | Claude Sonnet 5 / Claude Sonnet 5.5 | Claude Fable 5.1 / Claude Fable 5.2 | GPT-6.1 Sol / GPT-6.2 Sol | GPT-6 Astra / GPT-6.2 Astra | GPT-6 Luna | GPT-6.1 Terra | Claude Haiku 5.5 |
|---|---|---|---|---|---|---|---|---|
| 2026-W47 | 74.7 (Claude Opus 5.5) | 60.8 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 84.6 (GPT-6.2 Sol) | 78.5 (GPT-6.2 Astra) | 34.9 (GPT-6 Luna) | 70.7 (GPT-6.1 Terra) | 72.6 (Claude Haiku 5.5) |
| 2026-W46 | 74.8 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 72.5 (GPT-6.1 Sol) | 79.1 (GPT-6 Astra) | 38.8 (GPT-6 Luna) | 70.3 (GPT-6.1 Terra) | 65.3 (Claude Haiku 5.5) |
| 2026-W45 | 80.1 (Claude Opus 5.5) | 56.7 (Claude Sonnet 5.5) | 77.8 (Claude Fable 5.1) | 76.4 (GPT-6.1 Sol) | 78 (GPT-6 Astra) | 41.8 (GPT-6 Luna) | 71.3 (GPT-6.1 Terra) | 66 (Claude Haiku 5.5) |
| 2026-W44 | 74.4 (Claude Opus 5.5) | 64.9 (Claude Sonnet 5.5) | 76.9 (Claude Fable 5.1) | 81.4 (GPT-6.1 Sol) | 77.7 (GPT-6 Astra) | 46.7 (GPT-6 Luna) | 73.1 (GPT-6.1 Terra) | 73.2 (Claude Haiku 5.5) |
| 2026-W43 | 75.9 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 75.7 (Claude Fable 5.1) | 72.5 (GPT-6.1 Sol) | 79.7 (GPT-6 Astra) | 33.9 (GPT-6 Luna) | - | 73.6 (Claude Haiku 5.5) |
| 2026-W42 | 75.1 (Claude Opus 5.5) | 67.4 (Claude Sonnet 5.5) | 69 (Claude Fable 5.1) | 77.9 (GPT-6.1 Sol) | 78.4 (GPT-6 Astra) | 43.7 (GPT-6 Luna) | - | 65.7 (Claude Haiku 5.5) |
| 2026-W41 | 78.5 (Claude Opus 5.5) | 48.1 (Claude Sonnet 5.5) | 74.6 (Claude Fable 5.1) | 74.7 (GPT-6.1 Sol) | 73.5 (GPT-6 Astra) | 30.9 (GPT-6 Luna) | - | 68.4 (Claude Haiku 5.5) |
| Référence initiale | 75.5 (Claude Opus 5) | 34.3 (Claude Sonnet 5) | 71.2 (Claude Fable 5.1) | 70.6 (GPT-6.1 Sol) | 77.5 (GPT-6 Astra) | 45.6 (GPT-6 Luna) | - | - |
Every weekly run
Generated from the same records as the chart. Each week has its own address, for example https://vibeide.dev/benchmark/#2026-w47. Download every run as CSV.
| Week | Run date | Model | Score | Change vs previous round |
|---|---|---|---|---|
| 2026-W47 | GPT-6.2 Sol | 84.6 | New model version | |
| 2026-W47 | Claude Fable 5.2 | 79.3 | 0.0 | |
| 2026-W47 | GPT-6.2 Astra | 78.5 | New model version | |
| 2026-W47 | Claude Opus 5.5 | 74.7 | -0.1 | |
| 2026-W47 | Claude Haiku 5.5 | 72.6 | +7.3 | |
| 2026-W47 | GPT-6.1 Terra | 70.7 | +0.4 | |
| 2026-W47 | Claude Sonnet 5.5 | 60.8 | -0.2 | |
| 2026-W47 | GPT-6 Luna | 34.9 | -3.9 | |
| 2026-W46 | Claude Fable 5.2 | 79.3 | New model version | |
| 2026-W46 | GPT-6 Astra | 79.1 | +1.1 | |
| 2026-W46 | Claude Opus 5.5 | 74.8 | -5.3 | |
| 2026-W46 | GPT-6.1 Sol | 72.5 | -3.9 | |
| 2026-W46 | GPT-6.1 Terra | 70.3 | -1.0 | |
| 2026-W46 | Claude Haiku 5.5 | 65.3 | -0.7 | |
| 2026-W46 | Claude Sonnet 5.5 | 61 | +4.3 | |
| 2026-W46 | GPT-6 Luna | 38.8 | -3.0 | |
| 2026-W45 | Claude Opus 5.5 | 80.1 | +5.7 | |
| 2026-W45 | GPT-6 Astra | 78 | +0.3 | |
| 2026-W45 | Claude Fable 5.1 | 77.8 | +0.9 | |
| 2026-W45 | GPT-6.1 Sol | 76.4 | -5.0 | |
| 2026-W45 | GPT-6.1 Terra | 71.3 | -1.8 | |
| 2026-W45 | Claude Haiku 5.5 | 66 | -7.2 | |
| 2026-W45 | Claude Sonnet 5.5 | 56.7 | -8.2 | |
| 2026-W45 | GPT-6 Luna | 41.8 | -4.9 | |
| 2026-W44 | GPT-6.1 Sol | 81.4 | +8.9 | |
| 2026-W44 | GPT-6 Astra | 77.7 | -2.0 | |
| 2026-W44 | Claude Fable 5.1 | 76.9 | +1.2 | |
| 2026-W44 | Claude Opus 5.5 | 74.4 | -1.5 | |
| 2026-W44 | Claude Haiku 5.5 | 73.2 | -0.4 | |
| 2026-W44 | GPT-6.1 Terra | 73.1 | First run | |
| 2026-W44 | Claude Sonnet 5.5 | 64.9 | +3.9 | |
| 2026-W44 | GPT-6 Luna | 46.7 | +12.8 | |
| 2026-W43 | GPT-6 Astra | 79.7 | +1.3 | |
| 2026-W43 | Claude Opus 5.5 | 75.9 | +0.8 | |
| 2026-W43 | Claude Fable 5.1 | 75.7 | +6.7 | |
| 2026-W43 | Claude Haiku 5.5 | 73.6 | +7.9 | |
| 2026-W43 | GPT-6.1 Sol | 72.5 | -5.4 | |
| 2026-W43 | Claude Sonnet 5.5 | 61 | -6.4 | |
| 2026-W43 | GPT-6 Luna | 33.9 | -9.8 | |
| 2026-W42 | GPT-6 Astra | 78.4 | +4.9 | |
| 2026-W42 | GPT-6.1 Sol | 77.9 | +3.2 | |
| 2026-W42 | Claude Opus 5.5 | 75.1 | -3.4 | |
| 2026-W42 | Claude Fable 5.1 | 69 | -5.6 | |
| 2026-W42 | Claude Sonnet 5.5 | 67.4 | +19.3 | |
| 2026-W42 | Claude Haiku 5.5 | 65.7 | -2.7 | |
| 2026-W42 | GPT-6 Luna | 43.7 | +12.8 | |
| 2026-W41 | Claude Opus 5.5 | 78.5 | New model version | |
| 2026-W41 | GPT-6.1 Sol | 74.7 | +4.1 | |
| 2026-W41 | Claude Fable 5.1 | 74.6 | +3.4 | |
| 2026-W41 | GPT-6 Astra | 73.5 | -4.0 | |
| 2026-W41 | Claude Haiku 5.5 | 68.4 | First run | |
| 2026-W41 | Claude Sonnet 5.5 | 48.1 | New model version | |
| 2026-W41 | GPT-6 Luna | 30.9 | -14.7 | |
| 2026-W41 (Starting baseline) | GPT-6 Astra | 77.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Opus 5 | 75.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Fable 5.1 | 71.2 | First run | |
| 2026-W41 (Starting baseline) | GPT-6.1 Sol | 70.6 | First run | |
| 2026-W41 (Starting baseline) | GPT-6 Luna | 45.6 | First run | |
| 2026-W41 (Starting baseline) | Claude Sonnet 5 | 34.3 | First run |
Comment cela fonctionne
Une seule consigne
La consigne décrit chaque forme de la cible avec des valeurs précises.
Un seul essai
Chaque modèle répond une seule fois au format JSON. Aucun indice, aucune sélection de la meilleure réponse parmi N essais.
Un seul score
Fidélité des formes et des couleurs à la cible, de 0 à 100.
Méthodologie complète, questions et citation
Last updated
La formule
pourcentage de recouvrement des volumes × proportion de cubes correctement colorésMesure par unités de 1 cm³. Empreinte de la consigne 08fb5a5773fe89e7. La référence initiale conserve les résultats originaux de la première manche.
Comment cela fonctionne
La consigne décrit toutes les formes du modèle de référence avec des valeurs numériques exactes. Chaque modèle répond uniquement en JSON : jusqu’à 150 blocs, chacun défini par une position, des dimensions et une couleur parmi 11. Le modèle ne dessine rien lui-même. Lorsqu’un essai est évalué, nous réalisons le rendu de ses blocs et du modèle de référence à partir des mêmes petits cubes, avec le même éclairage et la même caméra, puis nous publions les images.
Le score correspond au chevauchement des volumes de la sculpture et de la cible (intersection sur union, mesurée en cubes de 1 cm), multiplié par la proportion de cubes communs ayant la bonne couleur. Une boîte par forme donne un score inférieur à 40 ; découper chaque forme en tranches égales donne environ 50. Les pieds inclinés, les câbles fins et les têtes rondes favorisent les modèles qui planifient l’emplacement de chaque boîte. La vue Différence montre chaque cube manquant, en trop ou de couleur incorrecte.
Équitable et reproductible
La référence initiale correspond au premier cycle d’origine, conservé avec les dates réelles des mesures. Un deuxième cycle de mesures a été demandé pour le lancement. Les deux sont affichés ; aucun n’est antidaté ni retenu comme le meilleur des deux. Les cycles suivants suivent le calendrier hebdomadaire.
- Les mêmes consignes, le même programme de calcul du score et les mêmes paramètres chaque semaine. Les consignes v3 ont pour empreinte
08fb5a5773fe89e7; toute modification entraîne une nouvelle version et un nouveau graphique. - Chaque modèle répond une seule fois avec un effort de raisonnement moyen, via Claude Code ou Codex connecté avec un abonnement, de la même manière que VibeiDE les exécute. Sans outils, sans accès au Web, sans sélection de la meilleure réponse parmi N essais.
- Une réponse dans laquelle aucune boîte ne peut être évaluée (format autre que JSON, ou toutes les boîtes mal formées) constitue une erreur de format, pas une sculpture : le modèle est sollicité une nouvelle fois et cette nouvelle réponse perd 2 points.
- Les modèles sont exécutés l’un après l’autre, jamais en parallèle. Une réponse qui n’arrive pas dans les 40 minutes obtient 0.
- Le programme de notation est déterministe. Aucun modèle n’évalue un autre modèle.
Lire les consignes complètes (texte brut, 7,691 caractères). Les noms des modèles sont les alias proposés par chaque CLI ; la page consigne l’identifiant du modèle communiqué par la CLI.
Questions
Les performances de Claude ou GPT sont-elles bridées ?
Cette page ne permet pas de voir ce qui se passe chez un fournisseur, mais elle montre si un même nom de modèle obtient des scores différents au fil du temps sur une tâche figée. Une exécution par semaine ne représente qu’un seul échantillon : considérez donc une variation de quelques points comme du bruit et une baisse qui dure plusieurs semaines comme un signal.
Pourquoi aucun modèle ne peut-il atteindre 100 ?
La cible se compose de sphères, d’ellipsoïdes, de cylindres et de capsules inclinées, tandis que la réponse ne peut utiliser que 150 boîtes alignées sur les axes. Les boîtes ne peuvent pas épouser exactement les courbes : chaque réponse laisse donc une partie du volume non reproduite. Les meilleurs modèles consacrent leurs boîtes aux zones courbes, et leurs sculptures ressemblent davantage à la cible.
Comment les modèles sont-ils exécutés ?
Chaque modèle reçoit les consignes une seule fois via son outil officiel en ligne de commande, Claude Code ou Codex, connecté avec un abonnement classique, avec un effort de raisonnement moyen. Les outils, les sous-agents et l’accès au Web sont désactivés ; si une exécution utilise tout de même un outil, elle perd un quart de son score. Seule une réponse dans laquelle aucune boîte ne peut être évaluée donne lieu à une nouvelle tentative, et cette nouvelle réponse perd 2 points. La réponse est évaluée par un programme déterministe, et non par un autre modèle.
Pourquoi le benchmark est-il passé à la v3 ?
Les deux premières versions demandaient aux modèles d’aménager un bureau. Lors de leurs premières sessions, les meilleurs modèles ont obtenu 100 et 92, et tous les bureaux conformes se ressemblaient. Un benchmark où les meilleurs modèles atteignent le score maximal ne permet pas de montrer les progrès, et un benchmark où les réponses se ressemblent ne permet pas de montrer leur qualité. La v3 demande donc une sculpture dont la qualité se voit au premier coup d’œil.
Puis-je essayer le cahier des charges moi-même ?
Oui. Les consignes complètes sont publiques et disponibles en texte brut. Collez-les dans n’importe quel modèle et comparez sa réponse à la cible.
Cite this benchmark
- Title
- VibeiDE Robot scene v1: weekly Claude and GPT model tracking
- URL
https://vibeide.dev/benchmark/- Latest week
- 2026-W47, run
- Publisher
- Crowie s.r.o.
- Method
- Each model answers the same frozen brief once at medium reasoning effort, with no tools. A reply with no usable boxes is asked once more, with a 2-point penalty. Volume overlap against the target, weighted by color accuracy, from 0 to 100.
- Licence
- Benchmark data and charts are licensed under CC BY 4.0. Please credit 'VibeiDE benchmark' with a link to https://vibeide.dev/benchmark/.
Suggested citationCrowie s.r.o. (2026). VibeiDE Robot scene v1: weekly Claude and GPT model tracking, week 2026-W47. https://vibeide.dev/benchmark/#2026-w47