Qual é a IA que constrói melhor?
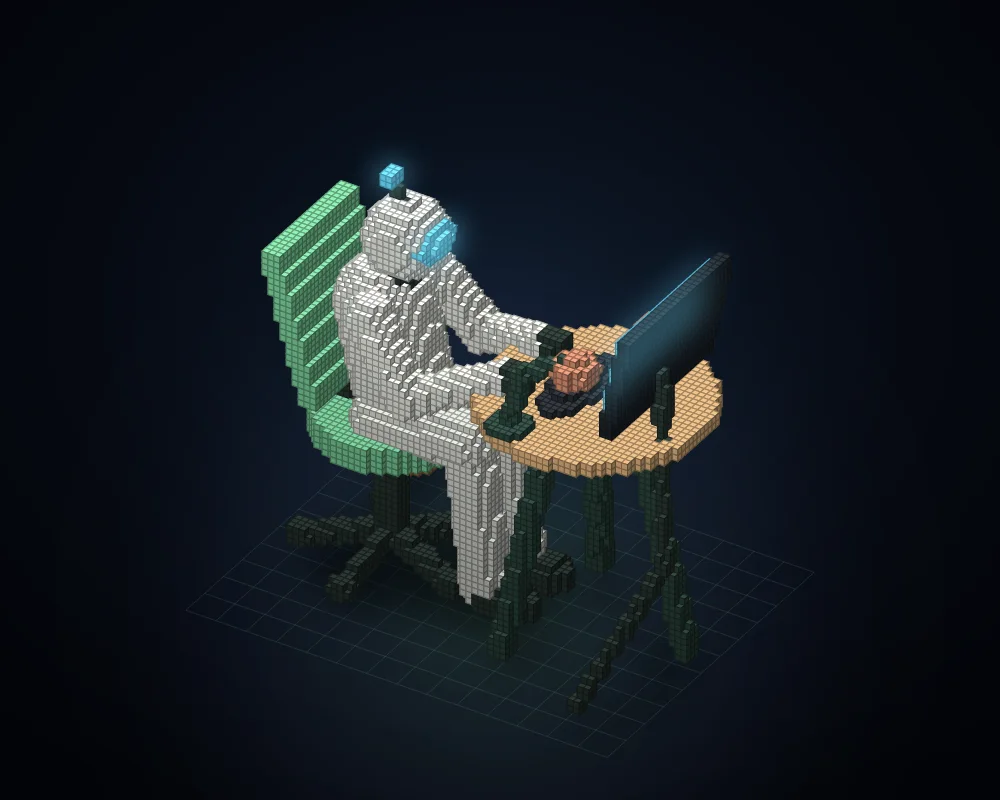
Oito modelos recebem as mesmas instruções e 150 retângulos. Cada um tem uma tentativa, avaliada de 0 a 100 por comparação com a imagem de referência exata. Há uma nova ronda todas as semanas.
Week 2026-W47, Nov 16 to 19
Esta semana
Week 2026-W47, Nov 16 to 19
Variação em relação à semana passada.
O que cada modelo criou
Resultados sem alterações, renderizados a partir do JSON devolvido por cada modelo. O contorno tracejado indica a imagem de referência.


Notas
O modelo perdeu capacidades?
As instruções são iguais todas as semanas, por isso vale a pena analisar um modelo cuja pontuação baixe de repente. Comparamos o resultado de cada ronda com a média do próprio modelo nas quatro rondas anteriores.
Que recursos foram necessários para cada resultado?
Total de tokens de entrada e de saída, e tempo decorrido, para a mesma semana. Nenhum outro modelo supera um modelo da linha tracejada tanto em pontuação como em custo.
Week 2026-W47
Ver as medições de tokens e tempo de execução
Porque variam as contagens de tokens de entrada? Todos os modelos recebem as mesmas instruções para o teste, mas estas contagens são comunicadas pelos fornecedores e abrangem toda a execução da CLI, incluindo as instruções incorporadas. Os modelos podem dividir o mesmo texto em tokens de formas diferentes, e os pedidos de continuação podem voltar a contabilizar o contexto. Os totais de entrada do Claude incluem os tokens fora da cache e os tokens lidos e escritos na cache. Os tokens de raciocínio só são contabilizados conforme o fornecedor os comunica. Os valores em falta ficam em branco. As contagens comunicadas não medem preços.
De ronda em ronda
A ronda inicial mantém os resultados originais. Cada ponto seguinte corresponde a uma nova ronda, medida nessa semana.
Ver as pontuações registadas
A referência inicial preserva os resultados originais da primeira ronda e as respetivas datas de medição.
| Ronda | Claude Opus 5 / Claude Opus 5.5 | Claude Sonnet 5 / Claude Sonnet 5.5 | Claude Fable 5.1 / Claude Fable 5.2 | GPT-6.1 Sol / GPT-6.2 Sol | GPT-6 Astra / GPT-6.2 Astra | GPT-6 Luna | GPT-6.1 Terra | Claude Haiku 5.5 |
|---|---|---|---|---|---|---|---|---|
| 2026-W47 | 74.7 (Claude Opus 5.5) | 60.8 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 84.6 (GPT-6.2 Sol) | 78.5 (GPT-6.2 Astra) | 34.9 (GPT-6 Luna) | 70.7 (GPT-6.1 Terra) | 72.6 (Claude Haiku 5.5) |
| 2026-W46 | 74.8 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 72.5 (GPT-6.1 Sol) | 79.1 (GPT-6 Astra) | 38.8 (GPT-6 Luna) | 70.3 (GPT-6.1 Terra) | 65.3 (Claude Haiku 5.5) |
| 2026-W45 | 80.1 (Claude Opus 5.5) | 56.7 (Claude Sonnet 5.5) | 77.8 (Claude Fable 5.1) | 76.4 (GPT-6.1 Sol) | 78 (GPT-6 Astra) | 41.8 (GPT-6 Luna) | 71.3 (GPT-6.1 Terra) | 66 (Claude Haiku 5.5) |
| 2026-W44 | 74.4 (Claude Opus 5.5) | 64.9 (Claude Sonnet 5.5) | 76.9 (Claude Fable 5.1) | 81.4 (GPT-6.1 Sol) | 77.7 (GPT-6 Astra) | 46.7 (GPT-6 Luna) | 73.1 (GPT-6.1 Terra) | 73.2 (Claude Haiku 5.5) |
| 2026-W43 | 75.9 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 75.7 (Claude Fable 5.1) | 72.5 (GPT-6.1 Sol) | 79.7 (GPT-6 Astra) | 33.9 (GPT-6 Luna) | - | 73.6 (Claude Haiku 5.5) |
| 2026-W42 | 75.1 (Claude Opus 5.5) | 67.4 (Claude Sonnet 5.5) | 69 (Claude Fable 5.1) | 77.9 (GPT-6.1 Sol) | 78.4 (GPT-6 Astra) | 43.7 (GPT-6 Luna) | - | 65.7 (Claude Haiku 5.5) |
| 2026-W41 | 78.5 (Claude Opus 5.5) | 48.1 (Claude Sonnet 5.5) | 74.6 (Claude Fable 5.1) | 74.7 (GPT-6.1 Sol) | 73.5 (GPT-6 Astra) | 30.9 (GPT-6 Luna) | - | 68.4 (Claude Haiku 5.5) |
| Referência inicial | 75.5 (Claude Opus 5) | 34.3 (Claude Sonnet 5) | 71.2 (Claude Fable 5.1) | 70.6 (GPT-6.1 Sol) | 77.5 (GPT-6 Astra) | 45.6 (GPT-6 Luna) | - | - |
Every weekly run
Generated from the same records as the chart. Each week has its own address, for example https://vibeide.dev/benchmark/#2026-w47. Download every run as CSV.
| Week | Run date | Model | Score | Change vs previous round |
|---|---|---|---|---|
| 2026-W47 | GPT-6.2 Sol | 84.6 | New model version | |
| 2026-W47 | Claude Fable 5.2 | 79.3 | 0.0 | |
| 2026-W47 | GPT-6.2 Astra | 78.5 | New model version | |
| 2026-W47 | Claude Opus 5.5 | 74.7 | -0.1 | |
| 2026-W47 | Claude Haiku 5.5 | 72.6 | +7.3 | |
| 2026-W47 | GPT-6.1 Terra | 70.7 | +0.4 | |
| 2026-W47 | Claude Sonnet 5.5 | 60.8 | -0.2 | |
| 2026-W47 | GPT-6 Luna | 34.9 | -3.9 | |
| 2026-W46 | Claude Fable 5.2 | 79.3 | New model version | |
| 2026-W46 | GPT-6 Astra | 79.1 | +1.1 | |
| 2026-W46 | Claude Opus 5.5 | 74.8 | -5.3 | |
| 2026-W46 | GPT-6.1 Sol | 72.5 | -3.9 | |
| 2026-W46 | GPT-6.1 Terra | 70.3 | -1.0 | |
| 2026-W46 | Claude Haiku 5.5 | 65.3 | -0.7 | |
| 2026-W46 | Claude Sonnet 5.5 | 61 | +4.3 | |
| 2026-W46 | GPT-6 Luna | 38.8 | -3.0 | |
| 2026-W45 | Claude Opus 5.5 | 80.1 | +5.7 | |
| 2026-W45 | GPT-6 Astra | 78 | +0.3 | |
| 2026-W45 | Claude Fable 5.1 | 77.8 | +0.9 | |
| 2026-W45 | GPT-6.1 Sol | 76.4 | -5.0 | |
| 2026-W45 | GPT-6.1 Terra | 71.3 | -1.8 | |
| 2026-W45 | Claude Haiku 5.5 | 66 | -7.2 | |
| 2026-W45 | Claude Sonnet 5.5 | 56.7 | -8.2 | |
| 2026-W45 | GPT-6 Luna | 41.8 | -4.9 | |
| 2026-W44 | GPT-6.1 Sol | 81.4 | +8.9 | |
| 2026-W44 | GPT-6 Astra | 77.7 | -2.0 | |
| 2026-W44 | Claude Fable 5.1 | 76.9 | +1.2 | |
| 2026-W44 | Claude Opus 5.5 | 74.4 | -1.5 | |
| 2026-W44 | Claude Haiku 5.5 | 73.2 | -0.4 | |
| 2026-W44 | GPT-6.1 Terra | 73.1 | First run | |
| 2026-W44 | Claude Sonnet 5.5 | 64.9 | +3.9 | |
| 2026-W44 | GPT-6 Luna | 46.7 | +12.8 | |
| 2026-W43 | GPT-6 Astra | 79.7 | +1.3 | |
| 2026-W43 | Claude Opus 5.5 | 75.9 | +0.8 | |
| 2026-W43 | Claude Fable 5.1 | 75.7 | +6.7 | |
| 2026-W43 | Claude Haiku 5.5 | 73.6 | +7.9 | |
| 2026-W43 | GPT-6.1 Sol | 72.5 | -5.4 | |
| 2026-W43 | Claude Sonnet 5.5 | 61 | -6.4 | |
| 2026-W43 | GPT-6 Luna | 33.9 | -9.8 | |
| 2026-W42 | GPT-6 Astra | 78.4 | +4.9 | |
| 2026-W42 | GPT-6.1 Sol | 77.9 | +3.2 | |
| 2026-W42 | Claude Opus 5.5 | 75.1 | -3.4 | |
| 2026-W42 | Claude Fable 5.1 | 69 | -5.6 | |
| 2026-W42 | Claude Sonnet 5.5 | 67.4 | +19.3 | |
| 2026-W42 | Claude Haiku 5.5 | 65.7 | -2.7 | |
| 2026-W42 | GPT-6 Luna | 43.7 | +12.8 | |
| 2026-W41 | Claude Opus 5.5 | 78.5 | New model version | |
| 2026-W41 | GPT-6.1 Sol | 74.7 | +4.1 | |
| 2026-W41 | Claude Fable 5.1 | 74.6 | +3.4 | |
| 2026-W41 | GPT-6 Astra | 73.5 | -4.0 | |
| 2026-W41 | Claude Haiku 5.5 | 68.4 | First run | |
| 2026-W41 | Claude Sonnet 5.5 | 48.1 | New model version | |
| 2026-W41 | GPT-6 Luna | 30.9 | -14.7 | |
| 2026-W41 (Starting baseline) | GPT-6 Astra | 77.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Opus 5 | 75.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Fable 5.1 | 71.2 | First run | |
| 2026-W41 (Starting baseline) | GPT-6.1 Sol | 70.6 | First run | |
| 2026-W41 (Starting baseline) | GPT-6 Luna | 45.6 | First run | |
| 2026-W41 (Starting baseline) | Claude Sonnet 5 | 34.3 | First run |
Como funciona
Um único enunciado
O enunciado enumera todas as formas da imagem de referência com valores exatos.
Uma só tentativa
Cada modelo responde uma vez em JSON. Sem pistas nem seleção da melhor de N tentativas.
Uma só pontuação
Correspondência das formas e das cores com a imagem de referência, de 0 a 100.
Metodologia completa, perguntas e como citar
Last updated
A fórmula
percentagem de sobreposição de volume × proporção de cubos com a cor corretaMedido em unidades de 1 cm³. Impressão digital do enunciado 08fb5a5773fe89e7. A referência inicial preserva os resultados originais da primeira ronda.
Como funciona
As instruções enumeram todas as formas do modelo de referência com valores exatos. Cada modelo responde apenas em JSON: até 150 blocos, cada um com uma posição, um tamanho e uma de 11 cores. O modelo não desenha nada por si próprio. Quando atribuímos uma pontuação a uma execução, renderizamos os seus blocos e o modelo de referência com os mesmos pequenos cubos, com a mesma iluminação e câmara, e publicamos as imagens.
A pontuação corresponde à sobreposição de volume entre a escultura e o modelo de referência (interseção sobre união, medida em cubos de 1 cm), multiplicada pela proporção de cubos comuns com a cor correta. Usar uma caixa por forma dá menos de 40 pontos; dividir todas as formas em fatias iguais dá cerca de 50. As pernas inclinadas, os cabos finos e as cabeças redondas favorecem os modelos que planeiam a posição de cada caixa, e a vista Diferença mostra todos os cubos em falta, a mais ou com a cor incorreta.
Justo e repetível
A referência inicial corresponde à primeira ronda original, preservada com as datas reais das medições. Foi solicitada uma segunda ronda de medições para o lançamento. Ambas são apresentadas; nenhuma tem datas retroativas nem é escolhida por ser o melhor dos dois resultados. As rondas seguintes seguem o calendário semanal.
- O mesmo enunciado, o mesmo programa de avaliação e as mesmas definições todas as semanas. O enunciado v3 tem a impressão digital
08fb5a5773fe89e7; qualquer alteração dá início a uma nova versão e a um novo gráfico. - Cada modelo responde uma única vez com um nível médio de esforço de raciocínio, através do Claude Code ou do Codex, com sessão iniciada através de uma subscrição, tal como são executados no VibeiDE. Sem ferramentas, sem acesso à Web e sem escolher a melhor de N tentativas.
- Uma resposta em que não é possível pontuar nenhuma caixa (por não estar em JSON ou por todas as caixas estarem malformadas) é uma falha de formato, não uma escultura: pede-se ao modelo uma nova resposta, uma única vez, e essa resposta perde 2 pontos.
- Os modelos são executados um após o outro, nunca em paralelo. Uma resposta que não chegue no prazo de 40 minutos recebe 0 pontos.
- O programa de avaliação é determinístico. Nenhum modelo avalia outro modelo.
Leia o enunciado completo (texto simples, 7,691 caracteres). Os nomes dos modelos são os aliases disponibilizados por cada CLI; a página regista o identificador do modelo comunicado pela CLI.
Perguntas
Estão a reduzir as capacidades do Claude ou do GPT?
Esta página não permite ver o que se passa dentro de um fornecedor, mas mostra se o mesmo nome de modelo obtém pontuações diferentes na mesma tarefa fixa ao longo do tempo. Uma execução por semana é uma única amostra, por isso encare uma variação de alguns pontos como ruído e uma queda que persiste durante várias semanas como um sinal.
Porque é que nenhum modelo consegue chegar aos 100?
O modelo de referência é composto por esferas, elipsoides, cilindros e cápsulas inclinadas, mas a resposta só pode usar 150 caixas alinhadas com os eixos. As caixas não conseguem acompanhar as curvas com exatidão, pelo que todas as respostas perdem algum volume. Os melhores modelos concentram as caixas nas zonas curvas e as suas esculturas assemelham-se mais ao modelo de referência.
Como são executados os modelos?
Cada modelo recebe o enunciado uma única vez através da sua ferramenta oficial de linha de comandos, Claude Code ou Codex, com sessão iniciada através de uma subscrição normal e um nível médio de esforço de raciocínio. As ferramentas, os subagentes e o acesso à Web estão desativados; uma execução que, ainda assim, use uma ferramenta perde um quarto da sua pontuação. Só se pede uma nova resposta, uma única vez, quando não é possível pontuar nenhuma caixa da resposta original, e essa nova resposta perde 2 pontos. A resposta é pontuada por um programa determinístico, não por outro modelo.
Porque é que o teste de referência mudou para a v3?
As primeiras duas versões pediam aos modelos que organizassem um escritório. Nas primeiras rondas, os melhores modelos obtiveram 100 e 92 pontos, e todos os escritórios corretos tinham o mesmo aspeto. Um teste de referência em que os melhores modelos atingem a pontuação máxima não permite mostrar evolução, e um teste em que as respostas são semelhantes não permite mostrar qualidade. Por isso, a v3 pede uma escultura cuja qualidade seja visível à primeira vista.
Posso experimentar o enunciado?
Sim. O enunciado completo está disponível publicamente em texto simples. Cole-o em qualquer modelo e compare a resposta com o modelo de referência.
Cite this benchmark
- Title
- VibeiDE Robot scene v1: weekly Claude and GPT model tracking
- URL
https://vibeide.dev/benchmark/- Latest week
- 2026-W47, run
- Publisher
- Crowie s.r.o.
- Method
- Each model answers the same frozen brief once at medium reasoning effort, with no tools. A reply with no usable boxes is asked once more, with a 2-point penalty. Volume overlap against the target, weighted by color accuracy, from 0 to 100.
- Licence
- Benchmark data and charts are licensed under CC BY 4.0. Please credit 'VibeiDE benchmark' with a link to https://vibeide.dev/benchmark/.
Suggested citationCrowie s.r.o. (2026). VibeiDE Robot scene v1: weekly Claude and GPT model tracking, week 2026-W47. https://vibeide.dev/benchmark/#2026-w47