¿Qué IA construye mejor?
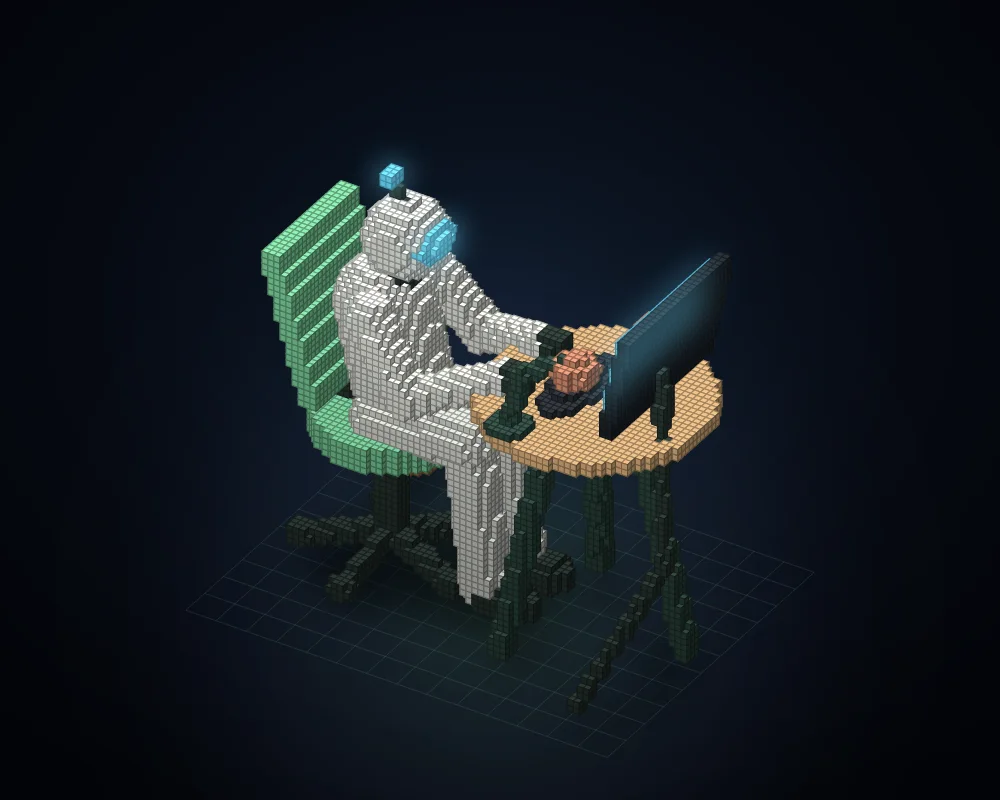
Ocho modelos reciben el mismo enunciado y 150 rectángulos. Cada uno tiene un único intento y recibe una puntuación de 0 a 100 según su fidelidad al objetivo exacto. Hay una ronda nueva cada semana.
Week 2026-W47, Nov 16 to 19
Esta semana
Week 2026-W47, Nov 16 to 19
Cambio respecto a la semana pasada.
Qué creó cada modelo
Resultado sin retoques, generado a partir del JSON que devolvió cada modelo. El contorno discontinuo marca el objetivo.


Notas
¿Han recortado sus capacidades?
El enunciado es el mismo cada semana, así que vale la pena examinar el caso de un modelo cuya puntuación baja de repente. Comparamos la puntuación de cada ronda con la media del propio modelo en las cuatro rondas anteriores.
¿Qué recursos requirió cada resultado?
Suma de los tokens de entrada y salida, y tiempo transcurrido en la misma semana. Ningún otro modelo supera a los de la línea discontinua tanto en puntuación como en coste.
Week 2026-W47
Consulta las mediciones de tokens y tiempo de ejecución
¿Por qué varían los tokens de entrada? Todos los modelos reciben el mismo enunciado de la prueba, pero los recuentos que comunican los proveedores corresponden a toda la ejecución de la CLI e incluyen las instrucciones integradas. Los modelos pueden tokenizar el mismo texto de forma distinta, y las peticiones de continuación pueden volver a contabilizar el contexto. Los totales de entrada de Claude incluyen los tokens sin caché y los correspondientes a las lecturas y escrituras de caché. Los tokens de razonamiento se contabilizan únicamente según lo que comunica el proveedor. Los valores que faltan se dejan en blanco. Los recuentos comunicados no indican los precios.
Evolución entre rondas
La ronda inicial conserva sus resultados originales. Cada punto posterior corresponde a una nueva ronda que se midió esa semana.
Consulta las puntuaciones registradas
La referencia inicial conserva los resultados originales de la primera ronda y las fechas de medición.
| Ronda | Claude Opus 5 / Claude Opus 5.5 | Claude Sonnet 5 / Claude Sonnet 5.5 | Claude Fable 5.1 / Claude Fable 5.2 | GPT-6.1 Sol / GPT-6.2 Sol | GPT-6 Astra / GPT-6.2 Astra | GPT-6 Luna | GPT-6.1 Terra | Claude Haiku 5.5 |
|---|---|---|---|---|---|---|---|---|
| 2026-W47 | 74.7 (Claude Opus 5.5) | 60.8 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 84.6 (GPT-6.2 Sol) | 78.5 (GPT-6.2 Astra) | 34.9 (GPT-6 Luna) | 70.7 (GPT-6.1 Terra) | 72.6 (Claude Haiku 5.5) |
| 2026-W46 | 74.8 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 72.5 (GPT-6.1 Sol) | 79.1 (GPT-6 Astra) | 38.8 (GPT-6 Luna) | 70.3 (GPT-6.1 Terra) | 65.3 (Claude Haiku 5.5) |
| 2026-W45 | 80.1 (Claude Opus 5.5) | 56.7 (Claude Sonnet 5.5) | 77.8 (Claude Fable 5.1) | 76.4 (GPT-6.1 Sol) | 78 (GPT-6 Astra) | 41.8 (GPT-6 Luna) | 71.3 (GPT-6.1 Terra) | 66 (Claude Haiku 5.5) |
| 2026-W44 | 74.4 (Claude Opus 5.5) | 64.9 (Claude Sonnet 5.5) | 76.9 (Claude Fable 5.1) | 81.4 (GPT-6.1 Sol) | 77.7 (GPT-6 Astra) | 46.7 (GPT-6 Luna) | 73.1 (GPT-6.1 Terra) | 73.2 (Claude Haiku 5.5) |
| 2026-W43 | 75.9 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 75.7 (Claude Fable 5.1) | 72.5 (GPT-6.1 Sol) | 79.7 (GPT-6 Astra) | 33.9 (GPT-6 Luna) | - | 73.6 (Claude Haiku 5.5) |
| 2026-W42 | 75.1 (Claude Opus 5.5) | 67.4 (Claude Sonnet 5.5) | 69 (Claude Fable 5.1) | 77.9 (GPT-6.1 Sol) | 78.4 (GPT-6 Astra) | 43.7 (GPT-6 Luna) | - | 65.7 (Claude Haiku 5.5) |
| 2026-W41 | 78.5 (Claude Opus 5.5) | 48.1 (Claude Sonnet 5.5) | 74.6 (Claude Fable 5.1) | 74.7 (GPT-6.1 Sol) | 73.5 (GPT-6 Astra) | 30.9 (GPT-6 Luna) | - | 68.4 (Claude Haiku 5.5) |
| Referencia inicial | 75.5 (Claude Opus 5) | 34.3 (Claude Sonnet 5) | 71.2 (Claude Fable 5.1) | 70.6 (GPT-6.1 Sol) | 77.5 (GPT-6 Astra) | 45.6 (GPT-6 Luna) | - | - |
Every weekly run
Generated from the same records as the chart. Each week has its own address, for example https://vibeide.dev/benchmark/#2026-w47. Download every run as CSV.
| Week | Run date | Model | Score | Change vs previous round |
|---|---|---|---|---|
| 2026-W47 | GPT-6.2 Sol | 84.6 | New model version | |
| 2026-W47 | Claude Fable 5.2 | 79.3 | 0.0 | |
| 2026-W47 | GPT-6.2 Astra | 78.5 | New model version | |
| 2026-W47 | Claude Opus 5.5 | 74.7 | -0.1 | |
| 2026-W47 | Claude Haiku 5.5 | 72.6 | +7.3 | |
| 2026-W47 | GPT-6.1 Terra | 70.7 | +0.4 | |
| 2026-W47 | Claude Sonnet 5.5 | 60.8 | -0.2 | |
| 2026-W47 | GPT-6 Luna | 34.9 | -3.9 | |
| 2026-W46 | Claude Fable 5.2 | 79.3 | New model version | |
| 2026-W46 | GPT-6 Astra | 79.1 | +1.1 | |
| 2026-W46 | Claude Opus 5.5 | 74.8 | -5.3 | |
| 2026-W46 | GPT-6.1 Sol | 72.5 | -3.9 | |
| 2026-W46 | GPT-6.1 Terra | 70.3 | -1.0 | |
| 2026-W46 | Claude Haiku 5.5 | 65.3 | -0.7 | |
| 2026-W46 | Claude Sonnet 5.5 | 61 | +4.3 | |
| 2026-W46 | GPT-6 Luna | 38.8 | -3.0 | |
| 2026-W45 | Claude Opus 5.5 | 80.1 | +5.7 | |
| 2026-W45 | GPT-6 Astra | 78 | +0.3 | |
| 2026-W45 | Claude Fable 5.1 | 77.8 | +0.9 | |
| 2026-W45 | GPT-6.1 Sol | 76.4 | -5.0 | |
| 2026-W45 | GPT-6.1 Terra | 71.3 | -1.8 | |
| 2026-W45 | Claude Haiku 5.5 | 66 | -7.2 | |
| 2026-W45 | Claude Sonnet 5.5 | 56.7 | -8.2 | |
| 2026-W45 | GPT-6 Luna | 41.8 | -4.9 | |
| 2026-W44 | GPT-6.1 Sol | 81.4 | +8.9 | |
| 2026-W44 | GPT-6 Astra | 77.7 | -2.0 | |
| 2026-W44 | Claude Fable 5.1 | 76.9 | +1.2 | |
| 2026-W44 | Claude Opus 5.5 | 74.4 | -1.5 | |
| 2026-W44 | Claude Haiku 5.5 | 73.2 | -0.4 | |
| 2026-W44 | GPT-6.1 Terra | 73.1 | First run | |
| 2026-W44 | Claude Sonnet 5.5 | 64.9 | +3.9 | |
| 2026-W44 | GPT-6 Luna | 46.7 | +12.8 | |
| 2026-W43 | GPT-6 Astra | 79.7 | +1.3 | |
| 2026-W43 | Claude Opus 5.5 | 75.9 | +0.8 | |
| 2026-W43 | Claude Fable 5.1 | 75.7 | +6.7 | |
| 2026-W43 | Claude Haiku 5.5 | 73.6 | +7.9 | |
| 2026-W43 | GPT-6.1 Sol | 72.5 | -5.4 | |
| 2026-W43 | Claude Sonnet 5.5 | 61 | -6.4 | |
| 2026-W43 | GPT-6 Luna | 33.9 | -9.8 | |
| 2026-W42 | GPT-6 Astra | 78.4 | +4.9 | |
| 2026-W42 | GPT-6.1 Sol | 77.9 | +3.2 | |
| 2026-W42 | Claude Opus 5.5 | 75.1 | -3.4 | |
| 2026-W42 | Claude Fable 5.1 | 69 | -5.6 | |
| 2026-W42 | Claude Sonnet 5.5 | 67.4 | +19.3 | |
| 2026-W42 | Claude Haiku 5.5 | 65.7 | -2.7 | |
| 2026-W42 | GPT-6 Luna | 43.7 | +12.8 | |
| 2026-W41 | Claude Opus 5.5 | 78.5 | New model version | |
| 2026-W41 | GPT-6.1 Sol | 74.7 | +4.1 | |
| 2026-W41 | Claude Fable 5.1 | 74.6 | +3.4 | |
| 2026-W41 | GPT-6 Astra | 73.5 | -4.0 | |
| 2026-W41 | Claude Haiku 5.5 | 68.4 | First run | |
| 2026-W41 | Claude Sonnet 5.5 | 48.1 | New model version | |
| 2026-W41 | GPT-6 Luna | 30.9 | -14.7 | |
| 2026-W41 (Starting baseline) | GPT-6 Astra | 77.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Opus 5 | 75.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Fable 5.1 | 71.2 | First run | |
| 2026-W41 (Starting baseline) | GPT-6.1 Sol | 70.6 | First run | |
| 2026-W41 (Starting baseline) | GPT-6 Luna | 45.6 | First run | |
| 2026-W41 (Starting baseline) | Claude Sonnet 5 | 34.3 | First run |
Cómo funciona
Un solo enunciado
El enunciado detalla cada forma del objetivo con valores exactos.
Un solo intento
Cada modelo responde una sola vez en JSON. Sin pistas ni selección de la mejor respuesta entre N intentos.
Una sola puntuación
Coincidencia de formas y colores con el objetivo, de 0 a 100.
Metodología completa, preguntas y cómo citar
Last updated
La fórmula
porcentaje de superposición de volumen × proporción de cubos con el color correctoMedido en unidades de 1 cm³. Huella digital de las instrucciones 08fb5a5773fe89e7. La referencia inicial conserva los resultados originales de la primera ronda.
Cómo funciona
El encargo enumera todas las formas del modelo de referencia con valores numéricos exactos. Cada modelo responde únicamente con JSON: hasta 150 bloques, cada uno con una posición, un tamaño y uno de los 11 colores. El modelo no dibuja nada por sí mismo. Al puntuar una ejecución, renderizamos sus bloques y el modelo de referencia con los mismos cubos pequeños, la misma iluminación y la misma cámara, y publicamos las imágenes.
La puntuación es el solapamiento de volumen entre la escultura y el modelo de referencia (intersección sobre unión, medida en cubos de 1 cm) multiplicado por la proporción de cubos compartidos que tienen el color correcto. Usar una caja por forma da menos de 40 puntos; dividir cada forma en láminas iguales da unos 50. Las patas inclinadas, los cables finos y las cabezas redondas favorecen a los modelos que planifican dónde colocar cada caja, y la vista Diferencia muestra todos los cubos ausentes, sobrantes y de color incorrecto.
Justo y reproducible
La referencia inicial es la primera ronda original, conservada con sus fechas reales de medición. Se solicitó una segunda ronda medida para el lanzamiento. Se muestran ambas; a ninguna se le asigna una fecha anterior ni se elige la mejor de las dos como resultado. Las rondas posteriores siguen el calendario semanal.
- Las mismas instrucciones, el mismo programa de puntuación y los mismos ajustes cada semana. Las instrucciones v3 tienen la huella digital
08fb5a5773fe89e7; cualquier cambio inicia una nueva versión y un nuevo gráfico. - Cada modelo responde una sola vez con un nivel medio de esfuerzo de razonamiento, a través de Claude Code o Codex con una sesión iniciada mediante una suscripción, del mismo modo que los ejecuta VibeiDE. Sin herramientas, sin acceso a la web y sin elegir el mejor de N intentos.
- Una respuesta en la que no se puede puntuar ninguna caja (porque no es JSON o porque todas las cajas tienen un formato incorrecto) es un fallo de formato, no una escultura: se solicita al modelo un segundo intento y esa nueva respuesta pierde 2 puntos.
- Los modelos se ejecutan uno tras otro, nunca en paralelo. Una respuesta que no llega en 40 minutos obtiene 0.
- El programa de evaluación es determinista. Ningún modelo evalúa a otro.
Lee las instrucciones completas (texto sin formato, 7,691 caracteres). Los nombres de los modelos son los alias que ofrece cada CLI; la página registra el identificador del modelo que comunicó la CLI.
Preguntas
¿Están reduciendo las capacidades de Claude o GPT?
Esta página no puede ver lo que ocurre dentro de un proveedor, pero muestra si un mismo nombre de modelo obtiene puntuaciones distintas en una misma tarea fija a lo largo del tiempo. Una ejecución semanal es una sola muestra, así que considera las variaciones de unos pocos puntos como ruido y una caída que se mantenga durante varias semanas como una señal.
¿Por qué ningún modelo puede alcanzar los 100 puntos?
El modelo de referencia está formado por esferas, elipsoides, cilindros y cápsulas inclinadas, y la respuesta solo puede usar 150 cajas alineadas con los ejes. Las cajas no pueden seguir las curvas con exactitud, por lo que todas las respuestas pierden algo de volumen. Los mejores modelos concentran sus cajas en las zonas curvas, y sus esculturas se parecen más al modelo de referencia.
¿Cómo se ejecutan los modelos?
Cada modelo recibe las instrucciones una sola vez a través de su herramienta oficial de línea de comandos, Claude Code o Codex, con una sesión iniciada mediante una suscripción normal y un nivel medio de esfuerzo de razonamiento. Las herramientas, los subagentes y el acceso a la web están desactivados; si aun así se usa una herramienta durante la ejecución, se pierde una cuarta parte de la puntuación. Solo se solicita un segundo intento si no se puede puntuar ninguna caja de la respuesta, y esa nueva respuesta pierde 2 puntos. Un programa determinista puntúa la respuesta, no otro modelo.
¿Por qué la prueba pasó a la v3?
Las dos primeras versiones pedían a los modelos que distribuyeran una oficina. En sus primeras rondas, los mejores modelos obtuvieron 100 y 92 puntos, y todas las oficinas correctas tenían el mismo aspecto. Una prueba en la que los mejores modelos alcanzan la puntuación máxima no permite apreciar cambios, y una en la que las respuestas se parecen no permite apreciar la calidad. Por eso, la v3 pide una escultura cuya calidad se pueda apreciar de un vistazo.
¿Puedo probar las instrucciones por mi cuenta?
Sí. Las instrucciones completas son públicas y están disponibles en texto sin formato. Pégalas en cualquier modelo y compara su respuesta con el modelo de referencia.
Cite this benchmark
- Title
- VibeiDE Robot scene v1: weekly Claude and GPT model tracking
- URL
https://vibeide.dev/benchmark/- Latest week
- 2026-W47, run
- Publisher
- Crowie s.r.o.
- Method
- Each model answers the same frozen brief once at medium reasoning effort, with no tools. A reply with no usable boxes is asked once more, with a 2-point penalty. Volume overlap against the target, weighted by color accuracy, from 0 to 100.
- Licence
- Benchmark data and charts are licensed under CC BY 4.0. Please credit 'VibeiDE benchmark' with a link to https://vibeide.dev/benchmark/.
Suggested citationCrowie s.r.o. (2026). VibeiDE Robot scene v1: weekly Claude and GPT model tracking, week 2026-W47. https://vibeide.dev/benchmark/#2026-w47