Które AI buduje najlepiej?
Osiem modeli dostaje ten sam opis zadania i 150 prostokątów. Każdy ma jedną próbę, którą oceniamy w skali od 0 do 100 na podstawie zgodności z dokładnie określonym wzorcem. Co tydzień odbywa się nowa runda.
Week 2026-W47, Nov 16 to 19
W tym tygodniu
Week 2026-W47, Nov 16 to 19
Zmiana względem zeszłego tygodnia.
Co stworzył każdy model
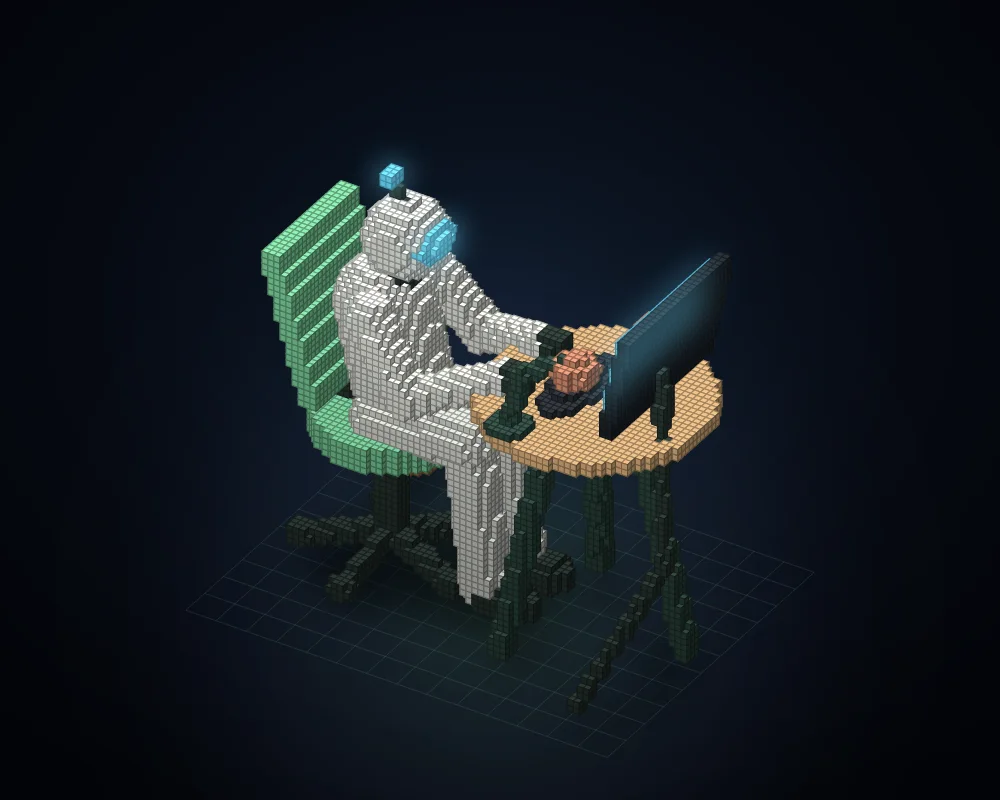
Wizualizacja surowych wyników na podstawie danych JSON zwróconych przez każdy model. Przerywany kontur oznacza wzorzec.


Uwagi
Czy model osłabł?
Co tydzień korzystamy z tego samego opisu zadania, więc nagły spadek wyniku modelu warto sprawdzić. Wynik każdej rundy porównujemy ze średnią wyników tego samego modelu z czterech poprzednich rund.
Ile zasobów wymagało uzyskanie każdego wyniku?
Łączna liczba tokenów wejściowych i wyjściowych oraz czas wykonania w tym samym tygodniu. Żaden inny model nie osiąga jednocześnie lepszego wyniku i niższego kosztu niż którykolwiek z modeli na linii przerywanej.
Week 2026-W47
Zobacz pomiary liczby tokenów i czasu wykonania
Dlaczego liczba tokenów wejściowych się różni? Każdy model dostaje ten sam opis zadania testowego, ale dostawcy podają liczbę tokenów dla całego uruchomienia CLI, łącznie z wbudowanymi instrukcjami. Modele mogą inaczej dzielić ten sam tekst na tokeny, a przy żądaniach kontynuacji kontekst może zostać policzony ponownie. Łączna liczba tokenów wejściowych Claude obejmuje tokeny spoza pamięci podręcznej oraz tokeny odczytane z niej i do niej zapisane. Tokeny rozumowania uwzględniamy wyłącznie zgodnie z danymi dostawcy. Pola bez danych pozostają puste. Podane liczby tokenów nie określają cen.
Porównanie kolejnych rund
Runda początkowa zachowuje pierwotne wyniki. Każdy kolejny punkt przedstawia nową rundę z pomiarem z danego tygodnia.
Zobacz zapisane oceny
Punkt odniesienia zachowuje pierwotne wyniki i daty pomiarów z pierwszej rundy.
| Runda | Claude Opus 5 / Claude Opus 5.5 | Claude Sonnet 5 / Claude Sonnet 5.5 | Claude Fable 5.1 / Claude Fable 5.2 | GPT-6.1 Sol / GPT-6.2 Sol | GPT-6 Astra / GPT-6.2 Astra | GPT-6 Luna | GPT-6.1 Terra | Claude Haiku 5.5 |
|---|---|---|---|---|---|---|---|---|
| 2026-W47 | 74.7 (Claude Opus 5.5) | 60.8 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 84.6 (GPT-6.2 Sol) | 78.5 (GPT-6.2 Astra) | 34.9 (GPT-6 Luna) | 70.7 (GPT-6.1 Terra) | 72.6 (Claude Haiku 5.5) |
| 2026-W46 | 74.8 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 72.5 (GPT-6.1 Sol) | 79.1 (GPT-6 Astra) | 38.8 (GPT-6 Luna) | 70.3 (GPT-6.1 Terra) | 65.3 (Claude Haiku 5.5) |
| 2026-W45 | 80.1 (Claude Opus 5.5) | 56.7 (Claude Sonnet 5.5) | 77.8 (Claude Fable 5.1) | 76.4 (GPT-6.1 Sol) | 78 (GPT-6 Astra) | 41.8 (GPT-6 Luna) | 71.3 (GPT-6.1 Terra) | 66 (Claude Haiku 5.5) |
| 2026-W44 | 74.4 (Claude Opus 5.5) | 64.9 (Claude Sonnet 5.5) | 76.9 (Claude Fable 5.1) | 81.4 (GPT-6.1 Sol) | 77.7 (GPT-6 Astra) | 46.7 (GPT-6 Luna) | 73.1 (GPT-6.1 Terra) | 73.2 (Claude Haiku 5.5) |
| 2026-W43 | 75.9 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 75.7 (Claude Fable 5.1) | 72.5 (GPT-6.1 Sol) | 79.7 (GPT-6 Astra) | 33.9 (GPT-6 Luna) | - | 73.6 (Claude Haiku 5.5) |
| 2026-W42 | 75.1 (Claude Opus 5.5) | 67.4 (Claude Sonnet 5.5) | 69 (Claude Fable 5.1) | 77.9 (GPT-6.1 Sol) | 78.4 (GPT-6 Astra) | 43.7 (GPT-6 Luna) | - | 65.7 (Claude Haiku 5.5) |
| 2026-W41 | 78.5 (Claude Opus 5.5) | 48.1 (Claude Sonnet 5.5) | 74.6 (Claude Fable 5.1) | 74.7 (GPT-6.1 Sol) | 73.5 (GPT-6 Astra) | 30.9 (GPT-6 Luna) | - | 68.4 (Claude Haiku 5.5) |
| Początkowy punkt odniesienia | 75.5 (Claude Opus 5) | 34.3 (Claude Sonnet 5) | 71.2 (Claude Fable 5.1) | 70.6 (GPT-6.1 Sol) | 77.5 (GPT-6 Astra) | 45.6 (GPT-6 Luna) | - | - |
Every weekly run
Generated from the same records as the chart. Each week has its own address, for example https://vibeide.dev/benchmark/#2026-w47. Download every run as CSV.
| Week | Run date | Model | Score | Change vs previous round |
|---|---|---|---|---|
| 2026-W47 | GPT-6.2 Sol | 84.6 | New model version | |
| 2026-W47 | Claude Fable 5.2 | 79.3 | 0.0 | |
| 2026-W47 | GPT-6.2 Astra | 78.5 | New model version | |
| 2026-W47 | Claude Opus 5.5 | 74.7 | -0.1 | |
| 2026-W47 | Claude Haiku 5.5 | 72.6 | +7.3 | |
| 2026-W47 | GPT-6.1 Terra | 70.7 | +0.4 | |
| 2026-W47 | Claude Sonnet 5.5 | 60.8 | -0.2 | |
| 2026-W47 | GPT-6 Luna | 34.9 | -3.9 | |
| 2026-W46 | Claude Fable 5.2 | 79.3 | New model version | |
| 2026-W46 | GPT-6 Astra | 79.1 | +1.1 | |
| 2026-W46 | Claude Opus 5.5 | 74.8 | -5.3 | |
| 2026-W46 | GPT-6.1 Sol | 72.5 | -3.9 | |
| 2026-W46 | GPT-6.1 Terra | 70.3 | -1.0 | |
| 2026-W46 | Claude Haiku 5.5 | 65.3 | -0.7 | |
| 2026-W46 | Claude Sonnet 5.5 | 61 | +4.3 | |
| 2026-W46 | GPT-6 Luna | 38.8 | -3.0 | |
| 2026-W45 | Claude Opus 5.5 | 80.1 | +5.7 | |
| 2026-W45 | GPT-6 Astra | 78 | +0.3 | |
| 2026-W45 | Claude Fable 5.1 | 77.8 | +0.9 | |
| 2026-W45 | GPT-6.1 Sol | 76.4 | -5.0 | |
| 2026-W45 | GPT-6.1 Terra | 71.3 | -1.8 | |
| 2026-W45 | Claude Haiku 5.5 | 66 | -7.2 | |
| 2026-W45 | Claude Sonnet 5.5 | 56.7 | -8.2 | |
| 2026-W45 | GPT-6 Luna | 41.8 | -4.9 | |
| 2026-W44 | GPT-6.1 Sol | 81.4 | +8.9 | |
| 2026-W44 | GPT-6 Astra | 77.7 | -2.0 | |
| 2026-W44 | Claude Fable 5.1 | 76.9 | +1.2 | |
| 2026-W44 | Claude Opus 5.5 | 74.4 | -1.5 | |
| 2026-W44 | Claude Haiku 5.5 | 73.2 | -0.4 | |
| 2026-W44 | GPT-6.1 Terra | 73.1 | First run | |
| 2026-W44 | Claude Sonnet 5.5 | 64.9 | +3.9 | |
| 2026-W44 | GPT-6 Luna | 46.7 | +12.8 | |
| 2026-W43 | GPT-6 Astra | 79.7 | +1.3 | |
| 2026-W43 | Claude Opus 5.5 | 75.9 | +0.8 | |
| 2026-W43 | Claude Fable 5.1 | 75.7 | +6.7 | |
| 2026-W43 | Claude Haiku 5.5 | 73.6 | +7.9 | |
| 2026-W43 | GPT-6.1 Sol | 72.5 | -5.4 | |
| 2026-W43 | Claude Sonnet 5.5 | 61 | -6.4 | |
| 2026-W43 | GPT-6 Luna | 33.9 | -9.8 | |
| 2026-W42 | GPT-6 Astra | 78.4 | +4.9 | |
| 2026-W42 | GPT-6.1 Sol | 77.9 | +3.2 | |
| 2026-W42 | Claude Opus 5.5 | 75.1 | -3.4 | |
| 2026-W42 | Claude Fable 5.1 | 69 | -5.6 | |
| 2026-W42 | Claude Sonnet 5.5 | 67.4 | +19.3 | |
| 2026-W42 | Claude Haiku 5.5 | 65.7 | -2.7 | |
| 2026-W42 | GPT-6 Luna | 43.7 | +12.8 | |
| 2026-W41 | Claude Opus 5.5 | 78.5 | New model version | |
| 2026-W41 | GPT-6.1 Sol | 74.7 | +4.1 | |
| 2026-W41 | Claude Fable 5.1 | 74.6 | +3.4 | |
| 2026-W41 | GPT-6 Astra | 73.5 | -4.0 | |
| 2026-W41 | Claude Haiku 5.5 | 68.4 | First run | |
| 2026-W41 | Claude Sonnet 5.5 | 48.1 | New model version | |
| 2026-W41 | GPT-6 Luna | 30.9 | -14.7 | |
| 2026-W41 (Starting baseline) | GPT-6 Astra | 77.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Opus 5 | 75.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Fable 5.1 | 71.2 | First run | |
| 2026-W41 (Starting baseline) | GPT-6.1 Sol | 70.6 | First run | |
| 2026-W41 (Starting baseline) | GPT-6 Luna | 45.6 | First run | |
| 2026-W41 (Starting baseline) | Claude Sonnet 5 | 34.3 | First run |
Jak to działa
Jeden opis zadania
Opis zadania wymienia wszystkie kształty we wzorcu i podaje dokładne wartości liczbowe.
Jedna próba
Każdy model odpowiada raz w formacie JSON. Bez podpowiedzi i bez wybierania najlepszej z N prób.
Jedna ocena
Zgodność kształtów i kolorów ze wzorcem w skali od 0 do 100.
Pełna metodologia, pytania i sposób cytowania
Last updated
Wzór
procent pokrycia objętości × udział sześcianów o prawidłowym kolorzePomiar w jednostkach 1 cm³. Odcisk cyfrowy briefu 08fb5a5773fe89e7. Początkowy punkt odniesienia zachowuje oryginalne wyniki pierwszej rundy.
Jak to działa
Opis zadania wymienia wszystkie bryły wzorca wraz z dokładnymi wartościami liczbowymi. Każdy model odpowiada wyłącznie w formacie JSON: podaje do 150 prostopadłościanów, a dla każdego położenie, rozmiar i jeden z 11 kolorów. Model sam niczego nie rysuje. Przy ocenie danego wykonania renderujemy jego prostopadłościany oraz wzorzec z takich samych małych sześcianów, przy tym samym oświetleniu i ustawieniu kamery, a następnie publikujemy obrazy.
Wynik to stopień pokrywania się objętości rzeźby i wzorca (stosunek części wspólnej do sumy zbiorów, mierzony w sześcianach o boku 1 cm) pomnożony przez udział sześcianów części wspólnej o prawidłowym kolorze. Jeden prostopadłościan na bryłę daje mniej niż 40 punktów; podzielenie każdej bryły na warstwy o równej grubości daje około 50 punktów. Nachylone nogi, cienkie kable i okrągłe głowy premiują modele, które planują położenie każdego prostopadłościanu, a widok Różnice pokazuje każdy brakujący, nadmiarowy i nieprawidłowo pokolorowany sześcian.
Uczciwe i powtarzalne warunki
Początkowy punkt odniesienia to oryginalna pierwsza runda, zachowana wraz z rzeczywistymi datami pomiarów. Na premierę poproszono o drugą rundę z pomiarami. Pokazujemy obie; żadnej nie przypisano wcześniejszej daty ani nie wybrano jako lepszego z dwóch wyników. Kolejne rundy odbywają się zgodnie z cotygodniowym harmonogramem.
- Co tydzień to samo zadanie, ten sam program oceniający i te same ustawienia. Zadanie v3 ma odcisk cyfrowy
08fb5a5773fe89e7; każda zmiana oznacza nową wersję i nowy wykres. - Każdy model odpowiada jeden raz przy średnim poziomie rozumowania, za pośrednictwem Claude Code lub Codex, po zalogowaniu na konto z subskrypcją, tak samo jak przy uruchamianiu w VibeiDE. Bez narzędzi, bez dostępu do sieci i bez wybierania najlepszej z N odpowiedzi.
- Odpowiedź, w której nie da się ocenić żadnego pudełka (nie jest JSON-em lub wszystkie pudełka mają nieprawidłową strukturę), to błąd formatu, a nie rzeźba: model otrzymuje jeszcze jedną próbę, a za tę odpowiedź odejmuje się 2 punkty.
- Modele uruchamiane są jeden po drugim, nigdy równolegle. Jeśli odpowiedź nie nadejdzie w ciągu 40 minut, wynik wynosi 0.
- Ocenę wystawia deterministyczny program. Żaden model nie ocenia innego modelu.
Przeczytaj pełną treść zadania (zwykły tekst, 7,691 znaków). Nazwy modeli to aliasy dostępne w poszczególnych CLI; strona zapisuje identyfikator modelu zgłoszony przez CLI.
Pytania
Czy możliwości Claude lub GPT są ograniczane?
Ta strona nie daje wglądu w wewnętrzne działania dostawcy, ale pokazuje, czy model o tej samej nazwie z czasem uzyskuje inne wyniki w tym samym, niezmiennym zadaniu. Jedno uruchomienie tygodniowo to pojedyncza próba, więc zmianę o kilka punktów traktuj jako szum, a spadek utrzymujący się przez kilka tygodni jako sygnał.
Dlaczego żaden model nie może osiągnąć 100 punktów?
Wzorzec składa się z kul, elipsoid, walców i nachylonych kapsuł, a odpowiedź może zawierać tylko 150 prostopadłościanów o krawędziach równoległych do osi układu współrzędnych. Prostopadłościany nie mogą dokładnie odwzorować krzywizn, więc każda odpowiedź traci część objętości. Lepsze modele wykorzystują prostopadłościany tam, gdzie występują krzywizny, dzięki czemu ich rzeźby bardziej przypominają wzorzec.
Jak uruchamiane są modele?
Każdy model otrzymuje opis zadania jeden raz za pośrednictwem swojego oficjalnego narzędzia wiersza poleceń, Claude Code lub Codex, po zalogowaniu na konto ze zwykłą subskrypcją i przy średnim poziomie rozumowania. Narzędzia, podagenci i dostęp do sieci są wyłączone; jeśli mimo to model użyje narzędzia, traci jedną czwartą punktów za tę próbę. Ponowną próbę otrzymuje wyłącznie model, w którego odpowiedzi nie da się ocenić żadnego pudełka, a za tę odpowiedź odejmuje się 2 punkty. Odpowiedź ocenia deterministyczny program, a nie inny model.
Dlaczego benchmark przeszedł na v3?
W pierwszych dwóch wersjach modele miały zaprojektować układ biura. W pierwszych rundach najlepsze modele zdobyły 100 i 92 punkty, a każde poprawne biuro wyglądało tak samo. Benchmark, w którym najlepsze modele osiągają maksymalny wynik, nie pozwala pokazać postępu, a taki, w którym odpowiedzi wyglądają podobnie, nie pozwala pokazać jakości. Dlatego w v3 zadaniem jest stworzenie rzeźby, której jakość widać na pierwszy rzut oka.
Czy mogę samodzielnie wypróbować to zadanie?
Tak. Pełna treść zadania jest publicznie dostępna jako zwykły tekst. Wklej ją do dowolnego modelu i porównaj jego odpowiedź ze wzorcem.
Cite this benchmark
- Title
- VibeiDE Robot scene v1: weekly Claude and GPT model tracking
- URL
https://vibeide.dev/benchmark/- Latest week
- 2026-W47, run
- Publisher
- Crowie s.r.o.
- Method
- Each model answers the same frozen brief once at medium reasoning effort, with no tools. A reply with no usable boxes is asked once more, with a 2-point penalty. Volume overlap against the target, weighted by color accuracy, from 0 to 100.
- Licence
- Benchmark data and charts are licensed under CC BY 4.0. Please credit 'VibeiDE benchmark' with a link to https://vibeide.dev/benchmark/.
Suggested citationCrowie s.r.o. (2026). VibeiDE Robot scene v1: weekly Claude and GPT model tracking, week 2026-W47. https://vibeide.dev/benchmark/#2026-w47