Melyik AI épít a legjobban?
Nyolc modell ugyanazt a feladatleírást és ugyanazt a 150 téglalapot kapja. Mindegyik egyszer próbálkozhat, és 0-tól 100-ig kap pontot aszerint, hogy mennyire pontosan adja vissza a célképet. Minden héten új forduló indul.
Week 2026-W47, Nov 16 to 19
Ezen a héten
Week 2026-W47, Nov 16 to 19
Változás a múlt héthez képest.
Mit készítettek a modellek?
Nyers eredmény, közvetlenül az egyes modellek által visszaadott JSON-ból megjelenítve. A szaggatott körvonal a célképet jelöli.


Megjegyzések
Visszafogták a modellt?
A feladatleírás minden héten ugyanaz, így érdemes megnézni, mi történik, ha egy modell hirtelen kevesebb pontot kap. Minden forduló eredményét az adott modell előző négy fordulóban elért átlagához viszonyítjuk.
Mennyi erőforrást igényelt egy-egy eredmény?
Az ugyanazon a héten mért összes bemeneti és kimeneti token, valamint az eltelt idő. A szaggatott vonalon lévő modelleknél egyetlen másik modell sem ér el egyszerre magasabb pontszámot és alacsonyabb költséget.
Week 2026-W47
Nézd meg a tokenhasználat és a futásidő méréseit
Miért tér el a bemeneti tokenek száma? Minden modell ugyanazt a tesztfeladatot kapja, de a szolgáltatók a teljes CLI-futtatás tokenszámát jelentik, a beépített utasításokkal együtt. A modellek ugyanazt a szöveget eltérően bonthatják tokenekre, a folytatásra irányuló kéréseknél pedig a kontextus újra beleszámíthat. A Claude teljes bemeneti tokenszámába a gyorsítótárban nem szereplő tokenek, valamint a gyorsítótárból olvasott és az oda írt tokenek is beleszámítanak. A következtetéshez használt tokeneket csak úgy számoljuk, ahogyan a szolgáltató jelenti őket. A hiányzó értékek helyét üresen hagyjuk. A közölt tokenszámokból nem derülnek ki az árak.
Alakulás fordulóról fordulóra
A nyitóforduló eredeti eredményei megmaradnak. Utána minden adatpont egy új fordulót jelöl, amelyet az adott héten mértünk.
Nézd meg a rögzített pontszámokat
A kiindulási adatsor megőrzi az első forduló eredeti eredményeit és a mérések dátumait.
| Kör | Claude Opus 5 / Claude Opus 5.5 | Claude Sonnet 5 / Claude Sonnet 5.5 | Claude Fable 5.1 / Claude Fable 5.2 | GPT-6.1 Sol / GPT-6.2 Sol | GPT-6 Astra / GPT-6.2 Astra | GPT-6 Luna | GPT-6.1 Terra | Claude Haiku 5.5 |
|---|---|---|---|---|---|---|---|---|
| 2026-W47 | 74.7 (Claude Opus 5.5) | 60.8 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 84.6 (GPT-6.2 Sol) | 78.5 (GPT-6.2 Astra) | 34.9 (GPT-6 Luna) | 70.7 (GPT-6.1 Terra) | 72.6 (Claude Haiku 5.5) |
| 2026-W46 | 74.8 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 72.5 (GPT-6.1 Sol) | 79.1 (GPT-6 Astra) | 38.8 (GPT-6 Luna) | 70.3 (GPT-6.1 Terra) | 65.3 (Claude Haiku 5.5) |
| 2026-W45 | 80.1 (Claude Opus 5.5) | 56.7 (Claude Sonnet 5.5) | 77.8 (Claude Fable 5.1) | 76.4 (GPT-6.1 Sol) | 78 (GPT-6 Astra) | 41.8 (GPT-6 Luna) | 71.3 (GPT-6.1 Terra) | 66 (Claude Haiku 5.5) |
| 2026-W44 | 74.4 (Claude Opus 5.5) | 64.9 (Claude Sonnet 5.5) | 76.9 (Claude Fable 5.1) | 81.4 (GPT-6.1 Sol) | 77.7 (GPT-6 Astra) | 46.7 (GPT-6 Luna) | 73.1 (GPT-6.1 Terra) | 73.2 (Claude Haiku 5.5) |
| 2026-W43 | 75.9 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 75.7 (Claude Fable 5.1) | 72.5 (GPT-6.1 Sol) | 79.7 (GPT-6 Astra) | 33.9 (GPT-6 Luna) | - | 73.6 (Claude Haiku 5.5) |
| 2026-W42 | 75.1 (Claude Opus 5.5) | 67.4 (Claude Sonnet 5.5) | 69 (Claude Fable 5.1) | 77.9 (GPT-6.1 Sol) | 78.4 (GPT-6 Astra) | 43.7 (GPT-6 Luna) | - | 65.7 (Claude Haiku 5.5) |
| 2026-W41 | 78.5 (Claude Opus 5.5) | 48.1 (Claude Sonnet 5.5) | 74.6 (Claude Fable 5.1) | 74.7 (GPT-6.1 Sol) | 73.5 (GPT-6 Astra) | 30.9 (GPT-6 Luna) | - | 68.4 (Claude Haiku 5.5) |
| Kiindulási alap | 75.5 (Claude Opus 5) | 34.3 (Claude Sonnet 5) | 71.2 (Claude Fable 5.1) | 70.6 (GPT-6.1 Sol) | 77.5 (GPT-6 Astra) | 45.6 (GPT-6 Luna) | - | - |
Every weekly run
Generated from the same records as the chart. Each week has its own address, for example https://vibeide.dev/benchmark/#2026-w47. Download every run as CSV.
| Week | Run date | Model | Score | Change vs previous round |
|---|---|---|---|---|
| 2026-W47 | GPT-6.2 Sol | 84.6 | New model version | |
| 2026-W47 | Claude Fable 5.2 | 79.3 | 0.0 | |
| 2026-W47 | GPT-6.2 Astra | 78.5 | New model version | |
| 2026-W47 | Claude Opus 5.5 | 74.7 | -0.1 | |
| 2026-W47 | Claude Haiku 5.5 | 72.6 | +7.3 | |
| 2026-W47 | GPT-6.1 Terra | 70.7 | +0.4 | |
| 2026-W47 | Claude Sonnet 5.5 | 60.8 | -0.2 | |
| 2026-W47 | GPT-6 Luna | 34.9 | -3.9 | |
| 2026-W46 | Claude Fable 5.2 | 79.3 | New model version | |
| 2026-W46 | GPT-6 Astra | 79.1 | +1.1 | |
| 2026-W46 | Claude Opus 5.5 | 74.8 | -5.3 | |
| 2026-W46 | GPT-6.1 Sol | 72.5 | -3.9 | |
| 2026-W46 | GPT-6.1 Terra | 70.3 | -1.0 | |
| 2026-W46 | Claude Haiku 5.5 | 65.3 | -0.7 | |
| 2026-W46 | Claude Sonnet 5.5 | 61 | +4.3 | |
| 2026-W46 | GPT-6 Luna | 38.8 | -3.0 | |
| 2026-W45 | Claude Opus 5.5 | 80.1 | +5.7 | |
| 2026-W45 | GPT-6 Astra | 78 | +0.3 | |
| 2026-W45 | Claude Fable 5.1 | 77.8 | +0.9 | |
| 2026-W45 | GPT-6.1 Sol | 76.4 | -5.0 | |
| 2026-W45 | GPT-6.1 Terra | 71.3 | -1.8 | |
| 2026-W45 | Claude Haiku 5.5 | 66 | -7.2 | |
| 2026-W45 | Claude Sonnet 5.5 | 56.7 | -8.2 | |
| 2026-W45 | GPT-6 Luna | 41.8 | -4.9 | |
| 2026-W44 | GPT-6.1 Sol | 81.4 | +8.9 | |
| 2026-W44 | GPT-6 Astra | 77.7 | -2.0 | |
| 2026-W44 | Claude Fable 5.1 | 76.9 | +1.2 | |
| 2026-W44 | Claude Opus 5.5 | 74.4 | -1.5 | |
| 2026-W44 | Claude Haiku 5.5 | 73.2 | -0.4 | |
| 2026-W44 | GPT-6.1 Terra | 73.1 | First run | |
| 2026-W44 | Claude Sonnet 5.5 | 64.9 | +3.9 | |
| 2026-W44 | GPT-6 Luna | 46.7 | +12.8 | |
| 2026-W43 | GPT-6 Astra | 79.7 | +1.3 | |
| 2026-W43 | Claude Opus 5.5 | 75.9 | +0.8 | |
| 2026-W43 | Claude Fable 5.1 | 75.7 | +6.7 | |
| 2026-W43 | Claude Haiku 5.5 | 73.6 | +7.9 | |
| 2026-W43 | GPT-6.1 Sol | 72.5 | -5.4 | |
| 2026-W43 | Claude Sonnet 5.5 | 61 | -6.4 | |
| 2026-W43 | GPT-6 Luna | 33.9 | -9.8 | |
| 2026-W42 | GPT-6 Astra | 78.4 | +4.9 | |
| 2026-W42 | GPT-6.1 Sol | 77.9 | +3.2 | |
| 2026-W42 | Claude Opus 5.5 | 75.1 | -3.4 | |
| 2026-W42 | Claude Fable 5.1 | 69 | -5.6 | |
| 2026-W42 | Claude Sonnet 5.5 | 67.4 | +19.3 | |
| 2026-W42 | Claude Haiku 5.5 | 65.7 | -2.7 | |
| 2026-W42 | GPT-6 Luna | 43.7 | +12.8 | |
| 2026-W41 | Claude Opus 5.5 | 78.5 | New model version | |
| 2026-W41 | GPT-6.1 Sol | 74.7 | +4.1 | |
| 2026-W41 | Claude Fable 5.1 | 74.6 | +3.4 | |
| 2026-W41 | GPT-6 Astra | 73.5 | -4.0 | |
| 2026-W41 | Claude Haiku 5.5 | 68.4 | First run | |
| 2026-W41 | Claude Sonnet 5.5 | 48.1 | New model version | |
| 2026-W41 | GPT-6 Luna | 30.9 | -14.7 | |
| 2026-W41 (Starting baseline) | GPT-6 Astra | 77.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Opus 5 | 75.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Fable 5.1 | 71.2 | First run | |
| 2026-W41 (Starting baseline) | GPT-6.1 Sol | 70.6 | First run | |
| 2026-W41 (Starting baseline) | GPT-6 Luna | 45.6 | First run | |
| 2026-W41 (Starting baseline) | Claude Sonnet 5 | 34.3 | First run |
Hogyan működik?
Egy feladatleírás
A feladatleírás a célkép minden alakzatát pontos számadatokkal adja meg.
Egy próbálkozás
Minden modell egyszer válaszol, JSON-formátumban. Nincsenek tippek, és nem választjuk ki több próbálkozásból a legjobbat.
Egy pontszám
A célképpel való formai és színbeli egyezés pontszáma 0-tól 100-ig.
Teljes módszertan, kérdések és hivatkozás
Last updated
A képlet
térfogati átfedés %-ban × a helyes színű kockák aránya1 cm³-es egységekben mérve. A feladatleírás ujjlenyomata: 08fb5a5773fe89e7. A kiindulási referencia megőrzi az első forduló eredeti eredményeit.
Hogyan működik?
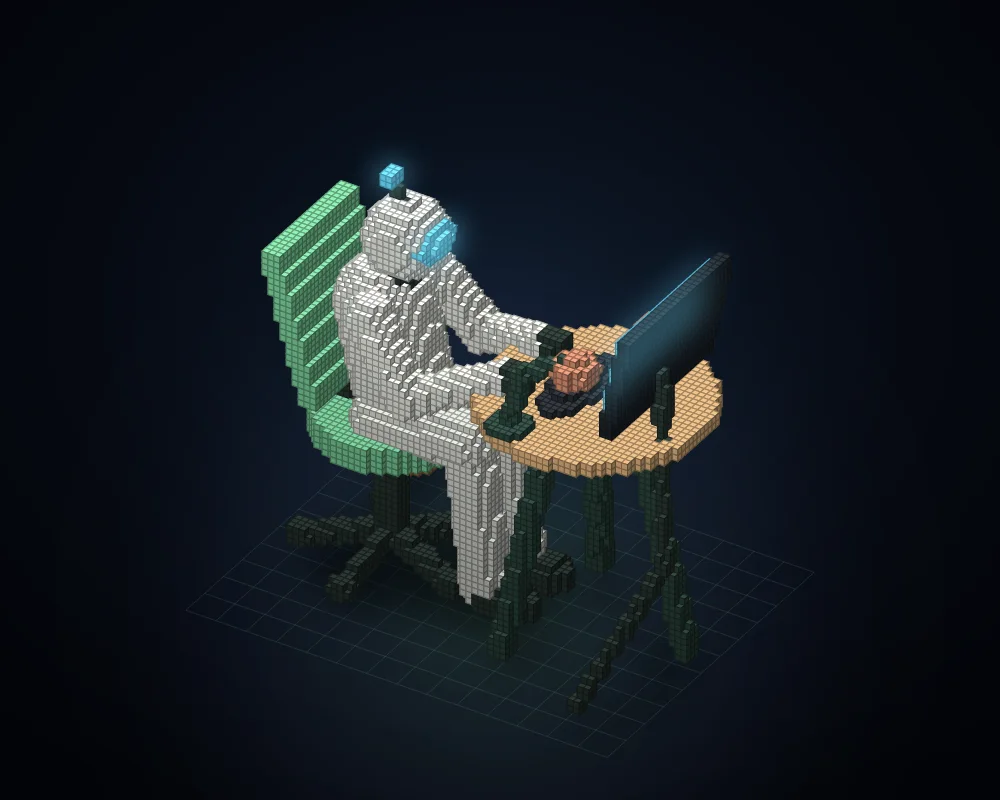
A feladatleírás pontos számadatokkal sorolja fel a minta minden alakzatát. Minden modell kizárólag JSON-nal válaszol: legfeljebb 150 téglatestet ad meg, mindegyikhez egy pozíciót, egy méretet és a 11 szín egyikét. Maga a modell semmit sem rajzol. Egy futás pontozásakor a téglatesteket és a mintát ugyanolyan kis kockákból, azonos megvilágítással és kamerabeállítással rendereljük, majd közzétesszük a képeket.
A pontszám a szobor és a minta térfogati átfedése (a metszet és az unió aránya, 1 cm-es kockákban mérve), megszorozva a közös kockák közül a megfelelő színűek arányával. Alakzatonként egy téglatesttel 40 alatti pontszám érhető el; minden alakzatot egyforma szeletekre bontva körülbelül 50 pont. A ferde lábak, a vékony kábelek és a kerek fejek azoknak a modelleknek kedveznek, amelyek megtervezik az egyes téglatestek helyét, az Eltérések nézet pedig minden hiányzó, felesleges és hibás színű kockát megmutat.
Méltányos és megismételhető
A kiindulási alap az eredeti első kör, amelyet a tényleges mérési dátumaival együtt őrzünk meg. Az induláshoz egy második mért kört is kértek. Mindkettőt megjelenítjük; egyiket sem dátumozzuk vissza, és nem választjuk ki közülük a jobbat. A későbbi körök a heti ütemezést követik.
- Minden héten ugyanaz a feladatleírás, pontozóprogram és beállítás. A v3 feladatleírás ujjlenyomata
08fb5a5773fe89e7; bármilyen módosítás új verziót és új diagramot indít. - Minden modell egyszer válaszol, közepes gondolkodási ráfordítással, előfizetéssel bejelentkezve a Claude Code-on vagy a Codexen keresztül, ugyanúgy, ahogyan a VibeiDE futtatja őket. Eszközök, webes hozzáférés és több futásból a legjobb kiválasztása nélkül.
- Az a válasz, amelyben egyetlen doboz sem pontozható (nem JSON, vagy minden doboz hibás formátumú), formátumhiba, nem szobor: a modelltől még egyszer választ kérünk, és ebből a válaszból 2 pontot levonunk.
- A modellek egymás után futnak, soha nem párhuzamosan. Ha 40 percen belül nem érkezik válasz, az eredmény 0 pont.
- A pontozó egy determinisztikus program. Egyetlen modell sem értékel másik modellt.
Olvasd el a teljes feladatleírást (egyszerű szöveg, 7,691 karakter). A modellnevek az egyes CLI-k által kínált aliasok; az oldal a CLI által visszajelzett modellazonosítót rögzíti.
Kérdések
Gyengítik a Claude-ot vagy a GPT-t?
Ez az oldal nem lát bele a szolgáltatók működésébe, de megmutatja, hogy ugyanaz a modellnév idővel eltérő pontszámot ér-e el ugyanazon a rögzített feladaton. A heti egy futtatás egyetlen mintát jelent, ezért a néhány pontos elmozdulást kezeld zajként, a több héten át tartó visszaesést pedig jelzésként.
Miért nem érheti el egyetlen modell sem a 100 pontot?
A minta gömbökből, ellipszoidokból, hengerekből és ferde kapszulákból áll, a válasz viszont csak 150, a koordinátatengelyekhez igazított téglatestet használhat. A téglatestek nem tudják pontosan követni az íveket, ezért minden válaszból hiányzik valamennyi térfogat. A jobb modellek az ívelt részekre fordítják a téglatesteket, így szobraik jobban hasonlítanak a mintához.
Hogyan futtatjuk a modelleket?
Minden modell egyszer kapja meg a feladatleírást a hivatalos parancssori eszközén, a Claude Code-on vagy a Codexen keresztül, normál előfizetéssel bejelentkezve, közepes gondolkodási ráfordítással. Az eszközök, az alügynökök és a webes hozzáférés ki vannak kapcsolva; ha egy futás mégis eszközt használ, elveszíti a pontszáma negyedét. Csak akkor kérünk még egy választ, ha az elsőben egyetlen doboz sem pontozható, és az új válaszból 2 pontot levonunk. A választ determinisztikus program pontozza, nem egy másik modell.
Miért váltott a teszt a v3 verzióra?
Az első két verzióban a modelleknek egy iroda elrendezését kellett megtervezniük. Az első fordulókban a legjobb modellek 100 és 92 pontot értek el, és minden helyes iroda ugyanúgy nézett ki. Ha a legjobb modellek elérik a teszt maximális pontszámát, az nem tudja megmutatni a fejlődést, ha pedig a válaszok egyformán néznek ki, a minőséget sem lehet érzékeltetni. Ezért a v3 olyan szobrot kér, amelynek minősége egy pillantással látható.
Én is kipróbálhatom a feladatot?
Igen. A teljes feladatleírás egyszerű szövegként nyilvánosan elérhető. Másold be bármelyik modellnek, és hasonlítsd össze a válaszát a mintával.
Cite this benchmark
- Title
- VibeiDE Robot scene v1: weekly Claude and GPT model tracking
- URL
https://vibeide.dev/benchmark/- Latest week
- 2026-W47, run
- Publisher
- Crowie s.r.o.
- Method
- Each model answers the same frozen brief once at medium reasoning effort, with no tools. A reply with no usable boxes is asked once more, with a 2-point penalty. Volume overlap against the target, weighted by color accuracy, from 0 to 100.
- Licence
- Benchmark data and charts are licensed under CC BY 4.0. Please credit 'VibeiDE benchmark' with a link to https://vibeide.dev/benchmark/.
Suggested citationCrowie s.r.o. (2026). VibeiDE Robot scene v1: weekly Claude and GPT model tracking, week 2026-W47. https://vibeide.dev/benchmark/#2026-w47