Welke AI bouwt het best?
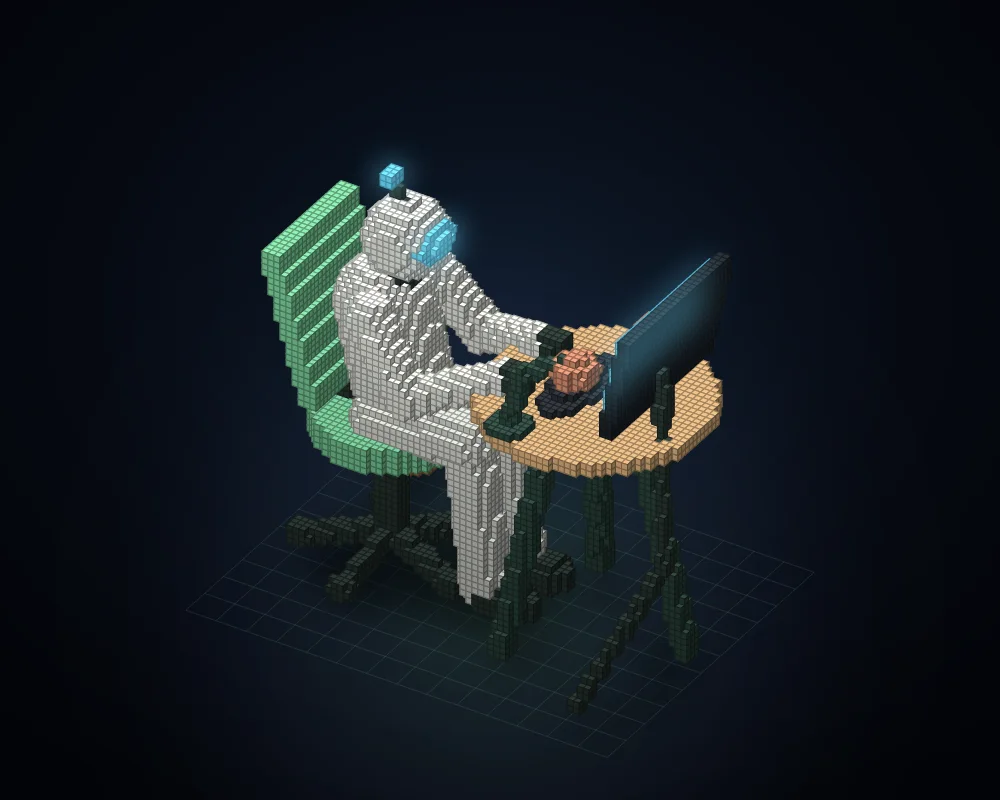
Acht modellen krijgen dezelfde opdracht en 150 rechthoeken. Elk model krijgt één poging en een score van 0 tot 100 op basis van hoe nauwkeurig het de doelafbeelding nabootst. Elke week is er een nieuwe ronde.
Week 2026-W47, Nov 16 to 19
Deze week
Week 2026-W47, Nov 16 to 19
Verschil met vorige week.
Wat elk model heeft gemaakt
De onbewerkte uitvoer, weergegeven op basis van de JSON die elk model terugstuurde. De stippelcontour geeft de doelafbeelding aan.


Opmerkingen
Is het model afgezwakt?
De opdracht is elke week hetzelfde, dus een model dat ineens lager scoort, verdient een nadere blik. We vergelijken elke ronde met het gemiddelde van datzelfde model over de vier voorgaande rondes.
Wat was er nodig voor elk resultaat?
Het totale aantal invoer- en uitvoertokens en de verstreken tijd voor dezelfde week. Bij elk model op de stippellijn geldt dat geen enkel ander model zowel een hogere score als lagere kosten heeft.
Week 2026-W47
Bekijk de metingen van tokengebruik en uitvoeringstijd
Waarom verschilt het aantal invoertokens? Elk model krijgt dezelfde benchmarkopdracht, maar de aantallen komen van de aanbieder en gelden voor de volledige CLI-uitvoering, inclusief ingebouwde instructies. Modellen kunnen dezelfde tekst verschillend opdelen in tokens en bij vervolgverzoeken kan de context opnieuw meetellen. De invoertotalen voor Claude omvatten tokens buiten de cache en tokens die uit de cache zijn gelezen of naar de cache zijn geschreven. Redeneertokens tellen alleen mee zoals de aanbieder ze rapporteert. Ontbrekende waarden blijven leeg. Uit de gerapporteerde aantallen kun je geen prijzen afleiden.
Van ronde tot ronde
De eerste ronde behoudt de oorspronkelijke resultaten. Elk punt daarna staat voor een nieuwe ronde die in die week is gemeten.
Bekijk de vastgelegde scores
De nulmeting bewaart de oorspronkelijke resultaten en meetdatums van de eerste ronde.
| Ronde | Claude Opus 5 / Claude Opus 5.5 | Claude Sonnet 5 / Claude Sonnet 5.5 | Claude Fable 5.1 / Claude Fable 5.2 | GPT-6.1 Sol / GPT-6.2 Sol | GPT-6 Astra / GPT-6.2 Astra | GPT-6 Luna | GPT-6.1 Terra | Claude Haiku 5.5 |
|---|---|---|---|---|---|---|---|---|
| 2026-W47 | 74.7 (Claude Opus 5.5) | 60.8 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 84.6 (GPT-6.2 Sol) | 78.5 (GPT-6.2 Astra) | 34.9 (GPT-6 Luna) | 70.7 (GPT-6.1 Terra) | 72.6 (Claude Haiku 5.5) |
| 2026-W46 | 74.8 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 72.5 (GPT-6.1 Sol) | 79.1 (GPT-6 Astra) | 38.8 (GPT-6 Luna) | 70.3 (GPT-6.1 Terra) | 65.3 (Claude Haiku 5.5) |
| 2026-W45 | 80.1 (Claude Opus 5.5) | 56.7 (Claude Sonnet 5.5) | 77.8 (Claude Fable 5.1) | 76.4 (GPT-6.1 Sol) | 78 (GPT-6 Astra) | 41.8 (GPT-6 Luna) | 71.3 (GPT-6.1 Terra) | 66 (Claude Haiku 5.5) |
| 2026-W44 | 74.4 (Claude Opus 5.5) | 64.9 (Claude Sonnet 5.5) | 76.9 (Claude Fable 5.1) | 81.4 (GPT-6.1 Sol) | 77.7 (GPT-6 Astra) | 46.7 (GPT-6 Luna) | 73.1 (GPT-6.1 Terra) | 73.2 (Claude Haiku 5.5) |
| 2026-W43 | 75.9 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 75.7 (Claude Fable 5.1) | 72.5 (GPT-6.1 Sol) | 79.7 (GPT-6 Astra) | 33.9 (GPT-6 Luna) | - | 73.6 (Claude Haiku 5.5) |
| 2026-W42 | 75.1 (Claude Opus 5.5) | 67.4 (Claude Sonnet 5.5) | 69 (Claude Fable 5.1) | 77.9 (GPT-6.1 Sol) | 78.4 (GPT-6 Astra) | 43.7 (GPT-6 Luna) | - | 65.7 (Claude Haiku 5.5) |
| 2026-W41 | 78.5 (Claude Opus 5.5) | 48.1 (Claude Sonnet 5.5) | 74.6 (Claude Fable 5.1) | 74.7 (GPT-6.1 Sol) | 73.5 (GPT-6 Astra) | 30.9 (GPT-6 Luna) | - | 68.4 (Claude Haiku 5.5) |
| Nulmeting | 75.5 (Claude Opus 5) | 34.3 (Claude Sonnet 5) | 71.2 (Claude Fable 5.1) | 70.6 (GPT-6.1 Sol) | 77.5 (GPT-6 Astra) | 45.6 (GPT-6 Luna) | - | - |
Every weekly run
Generated from the same records as the chart. Each week has its own address, for example https://vibeide.dev/benchmark/#2026-w47. Download every run as CSV.
| Week | Run date | Model | Score | Change vs previous round |
|---|---|---|---|---|
| 2026-W47 | GPT-6.2 Sol | 84.6 | New model version | |
| 2026-W47 | Claude Fable 5.2 | 79.3 | 0.0 | |
| 2026-W47 | GPT-6.2 Astra | 78.5 | New model version | |
| 2026-W47 | Claude Opus 5.5 | 74.7 | -0.1 | |
| 2026-W47 | Claude Haiku 5.5 | 72.6 | +7.3 | |
| 2026-W47 | GPT-6.1 Terra | 70.7 | +0.4 | |
| 2026-W47 | Claude Sonnet 5.5 | 60.8 | -0.2 | |
| 2026-W47 | GPT-6 Luna | 34.9 | -3.9 | |
| 2026-W46 | Claude Fable 5.2 | 79.3 | New model version | |
| 2026-W46 | GPT-6 Astra | 79.1 | +1.1 | |
| 2026-W46 | Claude Opus 5.5 | 74.8 | -5.3 | |
| 2026-W46 | GPT-6.1 Sol | 72.5 | -3.9 | |
| 2026-W46 | GPT-6.1 Terra | 70.3 | -1.0 | |
| 2026-W46 | Claude Haiku 5.5 | 65.3 | -0.7 | |
| 2026-W46 | Claude Sonnet 5.5 | 61 | +4.3 | |
| 2026-W46 | GPT-6 Luna | 38.8 | -3.0 | |
| 2026-W45 | Claude Opus 5.5 | 80.1 | +5.7 | |
| 2026-W45 | GPT-6 Astra | 78 | +0.3 | |
| 2026-W45 | Claude Fable 5.1 | 77.8 | +0.9 | |
| 2026-W45 | GPT-6.1 Sol | 76.4 | -5.0 | |
| 2026-W45 | GPT-6.1 Terra | 71.3 | -1.8 | |
| 2026-W45 | Claude Haiku 5.5 | 66 | -7.2 | |
| 2026-W45 | Claude Sonnet 5.5 | 56.7 | -8.2 | |
| 2026-W45 | GPT-6 Luna | 41.8 | -4.9 | |
| 2026-W44 | GPT-6.1 Sol | 81.4 | +8.9 | |
| 2026-W44 | GPT-6 Astra | 77.7 | -2.0 | |
| 2026-W44 | Claude Fable 5.1 | 76.9 | +1.2 | |
| 2026-W44 | Claude Opus 5.5 | 74.4 | -1.5 | |
| 2026-W44 | Claude Haiku 5.5 | 73.2 | -0.4 | |
| 2026-W44 | GPT-6.1 Terra | 73.1 | First run | |
| 2026-W44 | Claude Sonnet 5.5 | 64.9 | +3.9 | |
| 2026-W44 | GPT-6 Luna | 46.7 | +12.8 | |
| 2026-W43 | GPT-6 Astra | 79.7 | +1.3 | |
| 2026-W43 | Claude Opus 5.5 | 75.9 | +0.8 | |
| 2026-W43 | Claude Fable 5.1 | 75.7 | +6.7 | |
| 2026-W43 | Claude Haiku 5.5 | 73.6 | +7.9 | |
| 2026-W43 | GPT-6.1 Sol | 72.5 | -5.4 | |
| 2026-W43 | Claude Sonnet 5.5 | 61 | -6.4 | |
| 2026-W43 | GPT-6 Luna | 33.9 | -9.8 | |
| 2026-W42 | GPT-6 Astra | 78.4 | +4.9 | |
| 2026-W42 | GPT-6.1 Sol | 77.9 | +3.2 | |
| 2026-W42 | Claude Opus 5.5 | 75.1 | -3.4 | |
| 2026-W42 | Claude Fable 5.1 | 69 | -5.6 | |
| 2026-W42 | Claude Sonnet 5.5 | 67.4 | +19.3 | |
| 2026-W42 | Claude Haiku 5.5 | 65.7 | -2.7 | |
| 2026-W42 | GPT-6 Luna | 43.7 | +12.8 | |
| 2026-W41 | Claude Opus 5.5 | 78.5 | New model version | |
| 2026-W41 | GPT-6.1 Sol | 74.7 | +4.1 | |
| 2026-W41 | Claude Fable 5.1 | 74.6 | +3.4 | |
| 2026-W41 | GPT-6 Astra | 73.5 | -4.0 | |
| 2026-W41 | Claude Haiku 5.5 | 68.4 | First run | |
| 2026-W41 | Claude Sonnet 5.5 | 48.1 | New model version | |
| 2026-W41 | GPT-6 Luna | 30.9 | -14.7 | |
| 2026-W41 (Starting baseline) | GPT-6 Astra | 77.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Opus 5 | 75.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Fable 5.1 | 71.2 | First run | |
| 2026-W41 (Starting baseline) | GPT-6.1 Sol | 70.6 | First run | |
| 2026-W41 (Starting baseline) | GPT-6 Luna | 45.6 | First run | |
| 2026-W41 (Starting baseline) | Claude Sonnet 5 | 34.3 | First run |
Hoe het werkt
Eén opdracht
De opdracht beschrijft elke vorm in de doelafbeelding met exacte getallen.
Eén poging
Elk model geeft één antwoord in JSON. Zonder hints of selectie van het beste antwoord uit N pogingen.
Eén score
Een score van 0 tot 100 voor hoe goed de vormen en kleuren overeenkomen met de doelafbeelding.
Volledige methode, vragen en bronvermelding
Last updated
De formule
volumeoverlap % × aandeel kubussen met de juiste kleurGemeten in eenheden van 1 cm³. Vingerafdruk van de opdracht 08fb5a5773fe89e7. De oorspronkelijke resultaten van de eerste ronde blijven behouden als uitgangsmeting.
Hoe het werkt
De opdracht beschrijft elke vorm van het voorbeeld met exacte getallen. Elk model antwoordt uitsluitend met JSON: maximaal 150 blokken, elk met een positie, afmetingen en een van 11 kleuren. Het model tekent zelf niets. Wanneer we een inzending beoordelen, renderen we de blokken en het voorbeeld met dezelfde kleine kubussen, dezelfde belichting en dezelfde camera, en publiceren we de beelden.
De score is de volumeoverlap tussen de sculptuur en het voorbeeld (doorsnede gedeeld door vereniging, gemeten in kubussen van 1 cm), vermenigvuldigd met het aandeel overlappende kubussen met de juiste kleur. Eén blok per vorm levert een score onder 40 op; elke vorm in gelijke plakken verdelen levert ongeveer 50 op. Schuine poten, dunne kabels en ronde hoofden belonen modellen die plannen waar elk blok moet komen. De weergave Verschil toont elke ontbrekende, extra en verkeerd gekleurde kubus.
Eerlijk en herhaalbaar
De nulmeting is de oorspronkelijke eerste ronde, bewaard met de werkelijke meetdatums. Voor de lancering is een tweede gemeten ronde aangevraagd. Beide worden getoond; geen van beide is van een eerdere datum voorzien of gekozen als het beste resultaat van de twee. Latere rondes volgen het wekelijkse schema.
- Elke week dezelfde opdracht, hetzelfde beoordelingsprogramma en dezelfde instellingen. Opdracht v3 heeft de vingerafdruk
08fb5a5773fe89e7; bij elke wijziging beginnen een nieuwe versie en een nieuwe grafiek. - Elk model antwoordt één keer met een gemiddelde redeneerinspanning, via Claude Code of Codex, aangemeld met een abonnement, op dezelfde manier waarop VibeiDE ze uitvoert. Geen tools, geen webtoegang, geen best-of-N.
- Een antwoord waarin geen enkel vak kan worden beoordeeld (geen JSON, of alle vakken hebben een ongeldige structuur) is een formaatfout, geen sculptuur: het model krijgt de opdracht nog één keer en dat antwoord krijgt 2 punten aftrek.
- Modellen worden na elkaar uitgevoerd, nooit parallel. Een antwoord dat niet binnen 40 minuten binnenkomt, scoort 0.
- Het beoordelingsprogramma is deterministisch. Geen enkel model beoordeelt een ander model.
Lees de volledige opdracht (platte tekst, 7,691 tekens). De modelnamen zijn de aliassen die elke CLI aanbiedt; de pagina legt de modelidentificatie vast die de CLI heeft gerapporteerd.
Vragen
Worden Claude of GPT minder krachtig gemaakt?
Deze pagina kan niet bij een aanbieder achter de schermen kijken, maar laat wel zien of dezelfde modelnaam door de tijd heen anders scoort op dezelfde vastgelegde opdracht. Eén uitvoering per week is één steekproef, dus beschouw een verschil van een paar punten als ruis en een daling die meerdere weken aanhoudt als een signaal.
Waarom haalt geen enkel model 100?
Het voorbeeld bestaat uit bollen, ellipsoïden, cilinders en schuine capsules, terwijl het antwoord uitsluitend uit maximaal 150 blokken mag bestaan die langs de coördinaatassen zijn uitgelijnd. Blokken kunnen rondingen niet exact volgen, waardoor elk antwoord wat volume mist. Betere modellen gebruiken hun blokken waar de rondingen zitten, waardoor hun sculpturen meer op het voorbeeld lijken.
Hoe worden de modellen uitgevoerd?
Elk model krijgt de opdracht één keer via zijn officiële opdrachtregeltool, Claude Code of Codex, aangemeld met een regulier abonnement en met een gemiddelde redeneerinspanning. Tools, subagents en webtoegang staan uit; als een model tijdens een run toch een tool gebruikt, verliest die run een kwart van zijn score. Alleen als geen enkel vak in een antwoord kan worden beoordeeld, krijgt het model de opdracht nog één keer, en dat antwoord krijgt 2 punten aftrek. Een deterministisch programma beoordeelt het antwoord, geen ander model.
Waarom is de benchmark overgestapt op v3?
In de eerste twee versies moesten modellen een kantoor inrichten. In de eerste rondes scoorden de beste modellen 100 en 92, en elk correct kantoor zag er hetzelfde uit. Een benchmark waarop de beste modellen de maximale score halen, kan geen verandering laten zien. En als alle antwoorden op elkaar lijken, wordt de kwaliteit niet zichtbaar. Daarom vraagt v3 om een sculptuur waarvan je de kwaliteit in één oogopslag kunt zien.
Kan ik de opdracht zelf proberen?
Ja. De volledige opdracht is openbaar beschikbaar als platte tekst. Plak die in een willekeurig model en vergelijk het antwoord met het voorbeeld.
Cite this benchmark
- Title
- VibeiDE Robot scene v1: weekly Claude and GPT model tracking
- URL
https://vibeide.dev/benchmark/- Latest week
- 2026-W47, run
- Publisher
- Crowie s.r.o.
- Method
- Each model answers the same frozen brief once at medium reasoning effort, with no tools. A reply with no usable boxes is asked once more, with a 2-point penalty. Volume overlap against the target, weighted by color accuracy, from 0 to 100.
- Licence
- Benchmark data and charts are licensed under CC BY 4.0. Please credit 'VibeiDE benchmark' with a link to https://vibeide.dev/benchmark/.
Suggested citationCrowie s.r.o. (2026). VibeiDE Robot scene v1: weekly Claude and GPT model tracking, week 2026-W47. https://vibeide.dev/benchmark/#2026-w47