Welche KI baut am besten?
Acht Modelle bekommen dieselbe Aufgabenbeschreibung und 150 Rechtecke. Jedes Modell hat einen Versuch und erhält je nach Übereinstimmung mit der exakten Vorlage 0 bis 100 Punkte. Jede Woche gibt es eine neue Runde.
Week 2026-W47, Nov 16 to 19
Diese Woche
Week 2026-W47, Nov 16 to 19
Veränderung gegenüber der Vorwoche.
Was die einzelnen Modelle erstellt haben
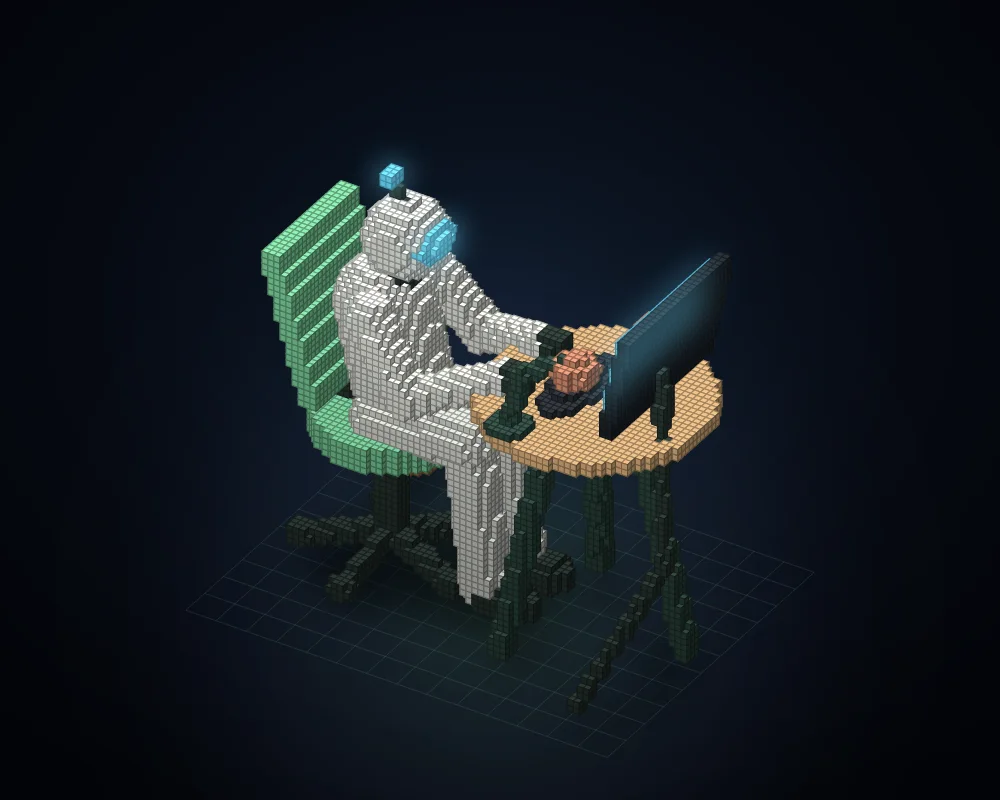
Die unveränderte Ausgabe als Bild, erzeugt aus dem JSON, das jedes Modell zurückgegeben hat. Die gestrichelte Kontur zeigt die Vorlage.


Hinweise
Wurde das Modell abgeschwächt?
Die Aufgabe ist jede Woche dieselbe. Wenn ein Modell plötzlich weniger Punkte erzielt, lohnt sich ein genauerer Blick. Wir vergleichen das Ergebnis jeder Runde mit dem Durchschnitt des jeweiligen Modells aus den vier vorangegangenen Runden.
Welchen Aufwand erforderte jedes Ergebnis?
Eingabe- und Ausgabetokens zusammen sowie die Laufzeit, jeweils aus derselben Woche. Bei den Modellen auf der gestrichelten Linie gibt es kein anderes Modell, das zugleich mehr Punkte erzielt und weniger kostet.
Week 2026-W47
Token- und Laufzeitmessungen ansehen
Warum unterscheidet sich die Zahl der Eingabetokens? Jedes Modell erhält dieselbe Benchmark-Aufgabe. Die hier gezeigten Tokenzahlen melden die Anbieter für den gesamten CLI-Lauf einschließlich der integrierten Anweisungen. Modelle können denselben Text unterschiedlich in Tokens zerlegen. Bei Folgeanfragen kann der Kontext erneut mitgezählt werden. Bei Claude umfasst die Gesamtzahl der Eingabetokens die Tokens ohne Cache sowie die beim Lesen und Schreiben des Caches gezählten Tokens. Reasoning-Tokens fließen so ein, wie der jeweilige Anbieter sie meldet. Fehlende Werte bleiben leer. Die gemeldeten Tokenzahlen geben keine Auskunft über die Preise.
Im Vergleich zur vorherigen Runde
Die Ergebnisse der ersten Runde bleiben unverändert erhalten. Jeder weitere Datenpunkt steht für eine neue Runde, die in der jeweiligen Woche gemessen wurde.
Erfasste Punktzahlen ansehen
Als Ausgangsbasis bleiben die ursprünglichen Ergebnisse und Messdaten der ersten Runde erhalten.
| Runde | Claude Opus 5 / Claude Opus 5.5 | Claude Sonnet 5 / Claude Sonnet 5.5 | Claude Fable 5.1 / Claude Fable 5.2 | GPT-6.1 Sol / GPT-6.2 Sol | GPT-6 Astra / GPT-6.2 Astra | GPT-6 Luna | GPT-6.1 Terra | Claude Haiku 5.5 |
|---|---|---|---|---|---|---|---|---|
| 2026-W47 | 74.7 (Claude Opus 5.5) | 60.8 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 84.6 (GPT-6.2 Sol) | 78.5 (GPT-6.2 Astra) | 34.9 (GPT-6 Luna) | 70.7 (GPT-6.1 Terra) | 72.6 (Claude Haiku 5.5) |
| 2026-W46 | 74.8 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 72.5 (GPT-6.1 Sol) | 79.1 (GPT-6 Astra) | 38.8 (GPT-6 Luna) | 70.3 (GPT-6.1 Terra) | 65.3 (Claude Haiku 5.5) |
| 2026-W45 | 80.1 (Claude Opus 5.5) | 56.7 (Claude Sonnet 5.5) | 77.8 (Claude Fable 5.1) | 76.4 (GPT-6.1 Sol) | 78 (GPT-6 Astra) | 41.8 (GPT-6 Luna) | 71.3 (GPT-6.1 Terra) | 66 (Claude Haiku 5.5) |
| 2026-W44 | 74.4 (Claude Opus 5.5) | 64.9 (Claude Sonnet 5.5) | 76.9 (Claude Fable 5.1) | 81.4 (GPT-6.1 Sol) | 77.7 (GPT-6 Astra) | 46.7 (GPT-6 Luna) | 73.1 (GPT-6.1 Terra) | 73.2 (Claude Haiku 5.5) |
| 2026-W43 | 75.9 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 75.7 (Claude Fable 5.1) | 72.5 (GPT-6.1 Sol) | 79.7 (GPT-6 Astra) | 33.9 (GPT-6 Luna) | - | 73.6 (Claude Haiku 5.5) |
| 2026-W42 | 75.1 (Claude Opus 5.5) | 67.4 (Claude Sonnet 5.5) | 69 (Claude Fable 5.1) | 77.9 (GPT-6.1 Sol) | 78.4 (GPT-6 Astra) | 43.7 (GPT-6 Luna) | - | 65.7 (Claude Haiku 5.5) |
| 2026-W41 | 78.5 (Claude Opus 5.5) | 48.1 (Claude Sonnet 5.5) | 74.6 (Claude Fable 5.1) | 74.7 (GPT-6.1 Sol) | 73.5 (GPT-6 Astra) | 30.9 (GPT-6 Luna) | - | 68.4 (Claude Haiku 5.5) |
| Ausgangsbasis | 75.5 (Claude Opus 5) | 34.3 (Claude Sonnet 5) | 71.2 (Claude Fable 5.1) | 70.6 (GPT-6.1 Sol) | 77.5 (GPT-6 Astra) | 45.6 (GPT-6 Luna) | - | - |
Every weekly run
Generated from the same records as the chart. Each week has its own address, for example https://vibeide.dev/benchmark/#2026-w47. Download every run as CSV.
| Week | Run date | Model | Score | Change vs previous round |
|---|---|---|---|---|
| 2026-W47 | GPT-6.2 Sol | 84.6 | New model version | |
| 2026-W47 | Claude Fable 5.2 | 79.3 | 0.0 | |
| 2026-W47 | GPT-6.2 Astra | 78.5 | New model version | |
| 2026-W47 | Claude Opus 5.5 | 74.7 | -0.1 | |
| 2026-W47 | Claude Haiku 5.5 | 72.6 | +7.3 | |
| 2026-W47 | GPT-6.1 Terra | 70.7 | +0.4 | |
| 2026-W47 | Claude Sonnet 5.5 | 60.8 | -0.2 | |
| 2026-W47 | GPT-6 Luna | 34.9 | -3.9 | |
| 2026-W46 | Claude Fable 5.2 | 79.3 | New model version | |
| 2026-W46 | GPT-6 Astra | 79.1 | +1.1 | |
| 2026-W46 | Claude Opus 5.5 | 74.8 | -5.3 | |
| 2026-W46 | GPT-6.1 Sol | 72.5 | -3.9 | |
| 2026-W46 | GPT-6.1 Terra | 70.3 | -1.0 | |
| 2026-W46 | Claude Haiku 5.5 | 65.3 | -0.7 | |
| 2026-W46 | Claude Sonnet 5.5 | 61 | +4.3 | |
| 2026-W46 | GPT-6 Luna | 38.8 | -3.0 | |
| 2026-W45 | Claude Opus 5.5 | 80.1 | +5.7 | |
| 2026-W45 | GPT-6 Astra | 78 | +0.3 | |
| 2026-W45 | Claude Fable 5.1 | 77.8 | +0.9 | |
| 2026-W45 | GPT-6.1 Sol | 76.4 | -5.0 | |
| 2026-W45 | GPT-6.1 Terra | 71.3 | -1.8 | |
| 2026-W45 | Claude Haiku 5.5 | 66 | -7.2 | |
| 2026-W45 | Claude Sonnet 5.5 | 56.7 | -8.2 | |
| 2026-W45 | GPT-6 Luna | 41.8 | -4.9 | |
| 2026-W44 | GPT-6.1 Sol | 81.4 | +8.9 | |
| 2026-W44 | GPT-6 Astra | 77.7 | -2.0 | |
| 2026-W44 | Claude Fable 5.1 | 76.9 | +1.2 | |
| 2026-W44 | Claude Opus 5.5 | 74.4 | -1.5 | |
| 2026-W44 | Claude Haiku 5.5 | 73.2 | -0.4 | |
| 2026-W44 | GPT-6.1 Terra | 73.1 | First run | |
| 2026-W44 | Claude Sonnet 5.5 | 64.9 | +3.9 | |
| 2026-W44 | GPT-6 Luna | 46.7 | +12.8 | |
| 2026-W43 | GPT-6 Astra | 79.7 | +1.3 | |
| 2026-W43 | Claude Opus 5.5 | 75.9 | +0.8 | |
| 2026-W43 | Claude Fable 5.1 | 75.7 | +6.7 | |
| 2026-W43 | Claude Haiku 5.5 | 73.6 | +7.9 | |
| 2026-W43 | GPT-6.1 Sol | 72.5 | -5.4 | |
| 2026-W43 | Claude Sonnet 5.5 | 61 | -6.4 | |
| 2026-W43 | GPT-6 Luna | 33.9 | -9.8 | |
| 2026-W42 | GPT-6 Astra | 78.4 | +4.9 | |
| 2026-W42 | GPT-6.1 Sol | 77.9 | +3.2 | |
| 2026-W42 | Claude Opus 5.5 | 75.1 | -3.4 | |
| 2026-W42 | Claude Fable 5.1 | 69 | -5.6 | |
| 2026-W42 | Claude Sonnet 5.5 | 67.4 | +19.3 | |
| 2026-W42 | Claude Haiku 5.5 | 65.7 | -2.7 | |
| 2026-W42 | GPT-6 Luna | 43.7 | +12.8 | |
| 2026-W41 | Claude Opus 5.5 | 78.5 | New model version | |
| 2026-W41 | GPT-6.1 Sol | 74.7 | +4.1 | |
| 2026-W41 | Claude Fable 5.1 | 74.6 | +3.4 | |
| 2026-W41 | GPT-6 Astra | 73.5 | -4.0 | |
| 2026-W41 | Claude Haiku 5.5 | 68.4 | First run | |
| 2026-W41 | Claude Sonnet 5.5 | 48.1 | New model version | |
| 2026-W41 | GPT-6 Luna | 30.9 | -14.7 | |
| 2026-W41 (Starting baseline) | GPT-6 Astra | 77.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Opus 5 | 75.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Fable 5.1 | 71.2 | First run | |
| 2026-W41 (Starting baseline) | GPT-6.1 Sol | 70.6 | First run | |
| 2026-W41 (Starting baseline) | GPT-6 Luna | 45.6 | First run | |
| 2026-W41 (Starting baseline) | Claude Sonnet 5 | 34.3 | First run |
So funktioniert es
Eine Aufgabe
Die Aufgabenbeschreibung führt jede Form der Vorlage mit exakten Zahlenwerten auf.
Ein Versuch
Jedes Modell antwortet einmal im JSON-Format. Es gibt keine Hinweise und keine Auswahl nach dem Best-of-N-Prinzip.
Eine Punktzahl
Je nach Übereinstimmung von Formen und Farben mit der Vorlage gibt es 0 bis 100 Punkte.
Vollständige Methodik, Fragen und Zitierhinweis
Last updated
Die Formel
Volumenüberschneidung in % × Anteil korrekt eingefärbter WürfelGemessen in Einheiten von 1 cm³. Fingerabdruck der Aufgabenbeschreibung: 08fb5a5773fe89e7. Die Ausgangsbasis bewahrt die ursprünglichen Ergebnisse der ersten Runde.
So funktioniert es
Die Aufgabenbeschreibung führt jede Form der Vorlage mit exakten Zahlen auf. Jedes Modell antwortet ausschließlich mit JSON: bis zu 150 Quader, jeweils mit einer Position, einer Größe und einer von 11 Farben. Das Modell zeichnet selbst nichts. Wenn ein Durchlauf bewertet wird, rendern wir seine Quader und die Vorlage aus denselben kleinen Würfeln, mit derselben Beleuchtung und Kamera, und veröffentlichen die Bilder.
Die Punktzahl ergibt sich aus der Volumenüberlappung zwischen Skulptur und Vorlage (Schnittmenge geteilt durch Vereinigungsmenge, gemessen in 1 cm großen Würfeln), multipliziert mit dem Anteil der überlappenden Würfel, die die richtige Farbe haben. Ein Quader pro Form ergibt weniger als 40 Punkte; wird jede Form in gleich große Scheiben zerlegt, sind es etwa 50 Punkte. Schräge Beine, dünne Kabel und runde Köpfe belohnen Modelle, die die Platzierung jedes Quaders planen. Die Ansicht „Unterschied“ zeigt jeden fehlenden, zusätzlichen und falsch eingefärbten Würfel.
Fair und wiederholbar
Die Ausgangsbasis ist die ursprüngliche erste Runde, deren tatsächliche Messdaten erhalten bleiben. Für den Launch wurde eine zweite gemessene Runde angefordert. Beide werden angezeigt; keine wird rückdatiert oder als bestes Ergebnis aus zwei Runden ausgewählt. Spätere Runden folgen dem wöchentlichen Zeitplan.
- Jede Woche dieselbe Aufgabenbeschreibung, dasselbe Bewertungsprogramm und dieselben Einstellungen. Die Aufgabenbeschreibung v3 hat den Fingerabdruck
08fb5a5773fe89e7; jede Änderung beginnt eine neue Version mit einem neuen Diagramm. - Jedes Modell antwortet einmal mit mittlerem Reasoning-Aufwand über Claude Code oder Codex, angemeldet mit einem Abonnement, genauso wie VibeiDE die Modelle ausführt. Keine Tools, kein Webzugriff, kein Best-of-N.
- Eine Antwort, in der sich keine einzige Box bewerten lässt (kein JSON oder alle Boxen fehlerhaft), gilt als Formatfehler, nicht als Skulptur: Das Modell wird ein weiteres Mal gefragt, und diese Antwort erhält 2 Punkte Abzug.
- Die Modelle laufen nacheinander, nie parallel. Eine Antwort, die nicht innerhalb von 40 Minuten eintrifft, erhält 0 Punkte.
- Das Bewertungsprogramm ist deterministisch. Kein Modell bewertet ein anderes Modell.
Lies die vollständige Aufgabenbeschreibung (Klartext, 7,691 Zeichen). Die Modellnamen sind die Aliasnamen, die die jeweilige CLI anbietet; die Seite erfasst die von der CLI gemeldete Modellkennung.
Fragen
Werden Claude oder GPT schlechter gemacht?
Diese Seite kann nicht hinter die Kulissen eines Anbieters schauen. Sie zeigt aber, ob dasselbe Modell unter demselben Namen bei derselben unveränderten Aufgabe im Laufe der Zeit anders abschneidet. Ein Durchlauf pro Woche ist nur eine einzelne Stichprobe. Betrachte eine Veränderung um wenige Punkte deshalb als Rauschen und einen Rückgang über mehrere Wochen als Signal.
Warum erreicht kein Modell 100 Punkte?
Die Vorlage besteht aus Kugeln, Ellipsoiden, Zylindern und schrägen Kapselformen, während die Antwort nur 150 achsenparallele Quader verwenden darf. Quader können Rundungen nicht exakt nachbilden, deshalb geht bei jeder Antwort etwas Volumen verloren. Bessere Modelle setzen ihre Quader gezielt an den Rundungen ein, sodass ihre Skulpturen der Vorlage stärker ähneln.
Wie werden die Modelle ausgeführt?
Jedes Modell erhält die Aufgabenbeschreibung einmal über sein offizielles Kommandozeilentool, Claude Code oder Codex, angemeldet mit einem regulären Abonnement und mit mittlerem Reasoning-Aufwand. Tools, Subagenten und Webzugriff sind deaktiviert; nutzt ein Durchlauf dennoch ein Tool, verliert er ein Viertel seiner Punktzahl. Nur wenn sich in einer Antwort keine einzige Box bewerten lässt, wird das Modell ein weiteres Mal gefragt, und diese Antwort erhält 2 Punkte Abzug. Die Antwort wird von einem deterministischen Programm bewertet, nicht von einem anderen Modell.
Warum wurde der Benchmark auf v3 umgestellt?
In den ersten beiden Versionen sollten die Modelle ein Büro einrichten. In den ersten Runden erreichten die besten Modelle 100 und 92 Punkte, und jedes korrekt eingerichtete Büro sah gleich aus. Ein Benchmark, bei dem Spitzenmodelle die Höchstpunktzahl erreichen, kann keine Veränderungen sichtbar machen. Wenn alle Antworten gleich aussehen, lässt sich auch die Qualität nicht erkennen. Deshalb verlangt v3 eine Skulptur, deren Qualität auf einen Blick sichtbar ist.
Kann ich die Aufgabe selbst ausprobieren?
Ja. Die vollständige Aufgabenbeschreibung ist als Klartext öffentlich zugänglich. Füge sie in ein beliebiges Modell ein und vergleiche seine Antwort mit der Vorlage.
Cite this benchmark
- Title
- VibeiDE Robot scene v1: weekly Claude and GPT model tracking
- URL
https://vibeide.dev/benchmark/- Latest week
- 2026-W47, run
- Publisher
- Crowie s.r.o.
- Method
- Each model answers the same frozen brief once at medium reasoning effort, with no tools. A reply with no usable boxes is asked once more, with a 2-point penalty. Volume overlap against the target, weighted by color accuracy, from 0 to 100.
- Licence
- Benchmark data and charts are licensed under CC BY 4.0. Please credit 'VibeiDE benchmark' with a link to https://vibeide.dev/benchmark/.
Suggested citationCrowie s.r.o. (2026). VibeiDE Robot scene v1: weekly Claude and GPT model tracking, week 2026-W47. https://vibeide.dev/benchmark/#2026-w47