Quale IA costruisce meglio?
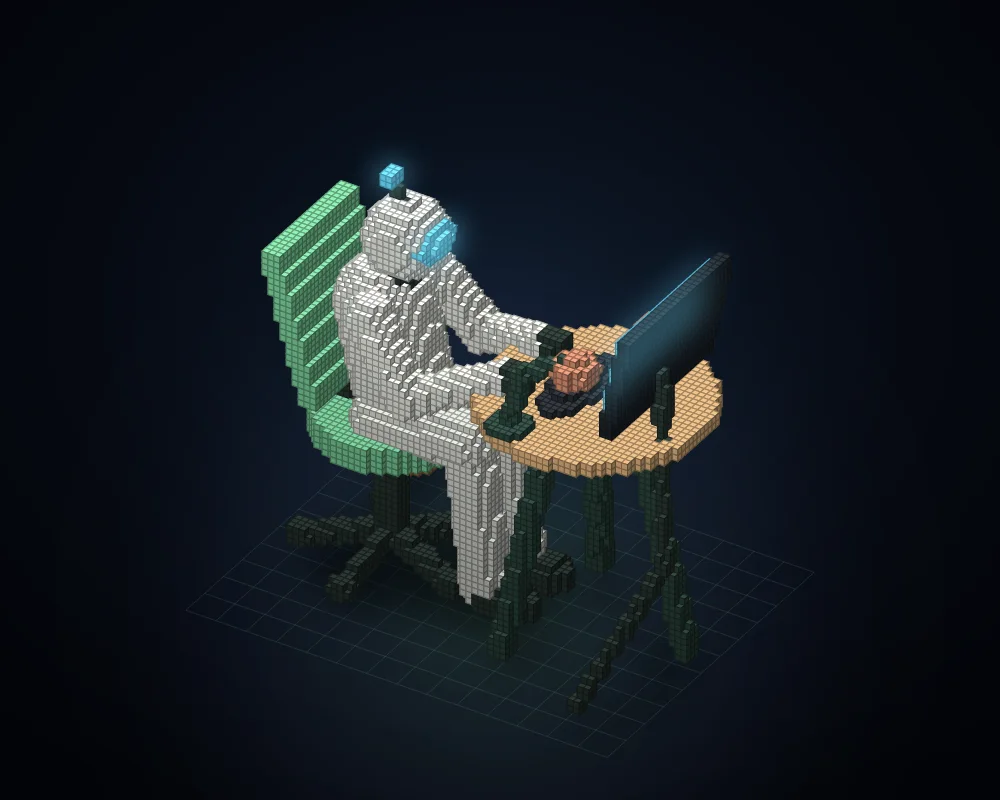
Otto modelli ricevono le stesse istruzioni e 150 rettangoli. Ognuno ha un solo tentativo, valutato da 0 a 100 in base alla corrispondenza con l’immagine di riferimento. Una nuova prova ogni settimana.
Week 2026-W47, Nov 16 to 19
Questa settimana
Week 2026-W47, Nov 16 to 19
Variazione rispetto alla settimana scorsa.
Cosa ha creato ogni modello
Risultato grezzo, visualizzato a partire dal JSON restituito da ogni modello. Il contorno tratteggiato indica l’immagine di riferimento.


Note
Il modello è stato depotenziato?
Le istruzioni sono le stesse ogni settimana, quindi vale la pena approfondire se il punteggio di un modello cala all’improvviso. Confrontiamo il punteggio di ogni prova con la media dello stesso modello nelle quattro prove precedenti.
Quali risorse ha richiesto ciascun risultato?
Somma dei token in ingresso e in uscita e tempo impiegato, per la stessa settimana. Per ciascun modello sulla linea tratteggiata, nessun altro modello ottiene contemporaneamente un punteggio più alto e un costo inferiore.
Week 2026-W47
Visualizza le misurazioni dei token e dei tempi di esecuzione
Perché il numero di token in ingresso varia? Ogni modello riceve le stesse istruzioni per il benchmark, ma i conteggi sono quelli comunicati dai provider per l’intera esecuzione della CLI e includono le istruzioni integrate. I modelli possono suddividere lo stesso testo in token diversi e le richieste di continuazione possono conteggiare di nuovo il contesto. I totali dei token in ingresso di Claude includono i token non memorizzati in cache, oltre alle letture e scritture in cache. I token di ragionamento vengono conteggiati solo secondo quanto riportato dal provider. I valori mancanti restano vuoti. I conteggi riportati non misurano i prezzi.
Andamento tra le prove
La prova iniziale conserva i risultati originali. Ogni punto successivo corrisponde a una nuova prova, misurata nella settimana indicata.
Visualizza i punteggi registrati
Il riferimento iniziale conserva i risultati originali della prima prova e le relative date di rilevazione.
| Ciclo | Claude Opus 5 / Claude Opus 5.5 | Claude Sonnet 5 / Claude Sonnet 5.5 | Claude Fable 5.1 / Claude Fable 5.2 | GPT-6.1 Sol / GPT-6.2 Sol | GPT-6 Astra / GPT-6.2 Astra | GPT-6 Luna | GPT-6.1 Terra | Claude Haiku 5.5 |
|---|---|---|---|---|---|---|---|---|
| 2026-W47 | 74.7 (Claude Opus 5.5) | 60.8 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 84.6 (GPT-6.2 Sol) | 78.5 (GPT-6.2 Astra) | 34.9 (GPT-6 Luna) | 70.7 (GPT-6.1 Terra) | 72.6 (Claude Haiku 5.5) |
| 2026-W46 | 74.8 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 79.3 (Claude Fable 5.2) | 72.5 (GPT-6.1 Sol) | 79.1 (GPT-6 Astra) | 38.8 (GPT-6 Luna) | 70.3 (GPT-6.1 Terra) | 65.3 (Claude Haiku 5.5) |
| 2026-W45 | 80.1 (Claude Opus 5.5) | 56.7 (Claude Sonnet 5.5) | 77.8 (Claude Fable 5.1) | 76.4 (GPT-6.1 Sol) | 78 (GPT-6 Astra) | 41.8 (GPT-6 Luna) | 71.3 (GPT-6.1 Terra) | 66 (Claude Haiku 5.5) |
| 2026-W44 | 74.4 (Claude Opus 5.5) | 64.9 (Claude Sonnet 5.5) | 76.9 (Claude Fable 5.1) | 81.4 (GPT-6.1 Sol) | 77.7 (GPT-6 Astra) | 46.7 (GPT-6 Luna) | 73.1 (GPT-6.1 Terra) | 73.2 (Claude Haiku 5.5) |
| 2026-W43 | 75.9 (Claude Opus 5.5) | 61 (Claude Sonnet 5.5) | 75.7 (Claude Fable 5.1) | 72.5 (GPT-6.1 Sol) | 79.7 (GPT-6 Astra) | 33.9 (GPT-6 Luna) | - | 73.6 (Claude Haiku 5.5) |
| 2026-W42 | 75.1 (Claude Opus 5.5) | 67.4 (Claude Sonnet 5.5) | 69 (Claude Fable 5.1) | 77.9 (GPT-6.1 Sol) | 78.4 (GPT-6 Astra) | 43.7 (GPT-6 Luna) | - | 65.7 (Claude Haiku 5.5) |
| 2026-W41 | 78.5 (Claude Opus 5.5) | 48.1 (Claude Sonnet 5.5) | 74.6 (Claude Fable 5.1) | 74.7 (GPT-6.1 Sol) | 73.5 (GPT-6 Astra) | 30.9 (GPT-6 Luna) | - | 68.4 (Claude Haiku 5.5) |
| Riferimento iniziale | 75.5 (Claude Opus 5) | 34.3 (Claude Sonnet 5) | 71.2 (Claude Fable 5.1) | 70.6 (GPT-6.1 Sol) | 77.5 (GPT-6 Astra) | 45.6 (GPT-6 Luna) | - | - |
Every weekly run
Generated from the same records as the chart. Each week has its own address, for example https://vibeide.dev/benchmark/#2026-w47. Download every run as CSV.
| Week | Run date | Model | Score | Change vs previous round |
|---|---|---|---|---|
| 2026-W47 | GPT-6.2 Sol | 84.6 | New model version | |
| 2026-W47 | Claude Fable 5.2 | 79.3 | 0.0 | |
| 2026-W47 | GPT-6.2 Astra | 78.5 | New model version | |
| 2026-W47 | Claude Opus 5.5 | 74.7 | -0.1 | |
| 2026-W47 | Claude Haiku 5.5 | 72.6 | +7.3 | |
| 2026-W47 | GPT-6.1 Terra | 70.7 | +0.4 | |
| 2026-W47 | Claude Sonnet 5.5 | 60.8 | -0.2 | |
| 2026-W47 | GPT-6 Luna | 34.9 | -3.9 | |
| 2026-W46 | Claude Fable 5.2 | 79.3 | New model version | |
| 2026-W46 | GPT-6 Astra | 79.1 | +1.1 | |
| 2026-W46 | Claude Opus 5.5 | 74.8 | -5.3 | |
| 2026-W46 | GPT-6.1 Sol | 72.5 | -3.9 | |
| 2026-W46 | GPT-6.1 Terra | 70.3 | -1.0 | |
| 2026-W46 | Claude Haiku 5.5 | 65.3 | -0.7 | |
| 2026-W46 | Claude Sonnet 5.5 | 61 | +4.3 | |
| 2026-W46 | GPT-6 Luna | 38.8 | -3.0 | |
| 2026-W45 | Claude Opus 5.5 | 80.1 | +5.7 | |
| 2026-W45 | GPT-6 Astra | 78 | +0.3 | |
| 2026-W45 | Claude Fable 5.1 | 77.8 | +0.9 | |
| 2026-W45 | GPT-6.1 Sol | 76.4 | -5.0 | |
| 2026-W45 | GPT-6.1 Terra | 71.3 | -1.8 | |
| 2026-W45 | Claude Haiku 5.5 | 66 | -7.2 | |
| 2026-W45 | Claude Sonnet 5.5 | 56.7 | -8.2 | |
| 2026-W45 | GPT-6 Luna | 41.8 | -4.9 | |
| 2026-W44 | GPT-6.1 Sol | 81.4 | +8.9 | |
| 2026-W44 | GPT-6 Astra | 77.7 | -2.0 | |
| 2026-W44 | Claude Fable 5.1 | 76.9 | +1.2 | |
| 2026-W44 | Claude Opus 5.5 | 74.4 | -1.5 | |
| 2026-W44 | Claude Haiku 5.5 | 73.2 | -0.4 | |
| 2026-W44 | GPT-6.1 Terra | 73.1 | First run | |
| 2026-W44 | Claude Sonnet 5.5 | 64.9 | +3.9 | |
| 2026-W44 | GPT-6 Luna | 46.7 | +12.8 | |
| 2026-W43 | GPT-6 Astra | 79.7 | +1.3 | |
| 2026-W43 | Claude Opus 5.5 | 75.9 | +0.8 | |
| 2026-W43 | Claude Fable 5.1 | 75.7 | +6.7 | |
| 2026-W43 | Claude Haiku 5.5 | 73.6 | +7.9 | |
| 2026-W43 | GPT-6.1 Sol | 72.5 | -5.4 | |
| 2026-W43 | Claude Sonnet 5.5 | 61 | -6.4 | |
| 2026-W43 | GPT-6 Luna | 33.9 | -9.8 | |
| 2026-W42 | GPT-6 Astra | 78.4 | +4.9 | |
| 2026-W42 | GPT-6.1 Sol | 77.9 | +3.2 | |
| 2026-W42 | Claude Opus 5.5 | 75.1 | -3.4 | |
| 2026-W42 | Claude Fable 5.1 | 69 | -5.6 | |
| 2026-W42 | Claude Sonnet 5.5 | 67.4 | +19.3 | |
| 2026-W42 | Claude Haiku 5.5 | 65.7 | -2.7 | |
| 2026-W42 | GPT-6 Luna | 43.7 | +12.8 | |
| 2026-W41 | Claude Opus 5.5 | 78.5 | New model version | |
| 2026-W41 | GPT-6.1 Sol | 74.7 | +4.1 | |
| 2026-W41 | Claude Fable 5.1 | 74.6 | +3.4 | |
| 2026-W41 | GPT-6 Astra | 73.5 | -4.0 | |
| 2026-W41 | Claude Haiku 5.5 | 68.4 | First run | |
| 2026-W41 | Claude Sonnet 5.5 | 48.1 | New model version | |
| 2026-W41 | GPT-6 Luna | 30.9 | -14.7 | |
| 2026-W41 (Starting baseline) | GPT-6 Astra | 77.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Opus 5 | 75.5 | First run | |
| 2026-W41 (Starting baseline) | Claude Fable 5.1 | 71.2 | First run | |
| 2026-W41 (Starting baseline) | GPT-6.1 Sol | 70.6 | First run | |
| 2026-W41 (Starting baseline) | GPT-6 Luna | 45.6 | First run | |
| 2026-W41 (Starting baseline) | Claude Sonnet 5 | 34.3 | First run |
Come funziona
Le stesse istruzioni per tutti
Le istruzioni elencano ogni forma dell’immagine di riferimento con valori esatti.
Un solo tentativo
Ogni modello risponde una sola volta in formato JSON. Nessun suggerimento e nessuna selezione della risposta migliore tra N tentativi.
Un solo punteggio
Corrispondenza delle forme e dei colori con l’immagine di riferimento, da 0 a 100.
Metodologia completa, domande e citazione
Last updated
La formula
percentuale di sovrapposizione dei volumi × quota di cubi con il colore correttoMisurata in unità di 1 cm³. Impronta digitale del brief 08fb5a5773fe89e7. La base di confronto iniziale conserva i risultati originali del primo round.
Come funziona
Le istruzioni elencano tutte le forme del modello di riferimento con valori numerici esatti. Ogni modello risponde esclusivamente in JSON: fino a 150 parallelepipedi, ciascuno definito da una posizione, dimensioni e uno degli 11 colori. Il modello non disegna nulla direttamente. Quando valutiamo un'esecuzione, renderizziamo i suoi parallelepipedi e il modello di riferimento usando gli stessi piccoli cubi, con la stessa illuminazione e la stessa inquadratura, e pubblichiamo le immagini.
Il punteggio è dato dalla sovrapposizione dei volumi della scultura e del modello di riferimento (intersezione divisa per unione, misurata in cubi da 1 cm), moltiplicata per la percentuale di cubi condivisi con il colore corretto. Usare un parallelepipedo per forma dà un punteggio inferiore a 40; suddividere ogni forma in strati uguali dà un punteggio di circa 50. Gambe inclinate, cavi sottili e teste rotonde premiano i modelli che pianificano dove collocare ogni parallelepipedo, e la vista Differenza mostra ogni cubo mancante, in eccesso o del colore sbagliato.
Equo e ripetibile
Il riferimento iniziale è il primo ciclo originale, conservato con le date effettive di misurazione. Per il lancio è stato richiesto un secondo ciclo misurato. Vengono mostrati entrambi: nessuno dei due è retrodatato e non viene selezionato soltanto il migliore dei due risultati. I cicli successivi seguono la cadenza settimanale.
- Ogni settimana si usano la stessa consegna, lo stesso programma di valutazione e le stesse impostazioni. La consegna v3 ha l'impronta
08fb5a5773fe89e7; qualsiasi modifica dà inizio a una nuova versione e a un nuovo grafico. - Ogni modello risponde una sola volta con un livello di ragionamento medio, tramite Claude Code o Codex con accesso tramite abbonamento, proprio come li esegue VibeiDE. Nessuno strumento, nessun accesso al web, nessuna selezione del migliore tra N tentativi.
- Una risposta in cui nessun riquadro è valutabile (non è in formato JSON oppure tutti i riquadri sono malformati) è un errore di formato, non una scultura: si richiede al modello un secondo tentativo, una sola volta, e la nuova risposta perde 2 punti.
- I modelli vengono eseguiti uno dopo l'altro, mai in parallelo. Una risposta che non arriva entro 40 minuti ottiene 0.
- Il programma di valutazione è deterministico. Nessun modello valuta un altro modello.
Leggi la consegna completa (testo semplice, 7,691 caratteri). I nomi dei modelli sono gli alias offerti da ciascuna CLI; la pagina registra l'identificatore del modello riportato dalla CLI.
Domande
Claude o GPT stanno diventando meno capaci?
Questa pagina non può sapere cosa succede all'interno di un fornitore, ma mostra se lo stesso nome di modello ottiene punteggi diversi nel tempo sulla stessa prova invariata. Una sola esecuzione a settimana è un singolo campione: considera quindi uno scostamento di pochi punti come rumore e un calo che dura diverse settimane come un segnale.
Perché nessun modello riesce a raggiungere 100?
Il modello di riferimento è composto da sfere, ellissoidi, cilindri e capsule inclinate, mentre la risposta può usare solo 150 parallelepipedi allineati agli assi. I parallelepipedi non possono seguire esattamente le curve, quindi ogni risposta perde una parte del volume. I modelli migliori concentrano i parallelepipedi dove ci sono le curve e producono sculture più simili al modello di riferimento.
Come vengono eseguiti i modelli?
Ogni modello riceve la consegna una sola volta tramite il proprio strumento ufficiale da riga di comando, Claude Code o Codex, con accesso tramite un normale abbonamento e un livello di ragionamento medio. Strumenti, sottoagenti e accesso al web sono disattivati; se un'esecuzione usa comunque uno strumento, perde un quarto del punteggio. Si richiede un secondo tentativo, una sola volta, soltanto se la risposta non contiene alcun riquadro valutabile, e la nuova risposta perde 2 punti. La risposta viene valutata da un programma deterministico, non da un altro modello.
Perché il benchmark è passato alla v3?
Le prime due versioni chiedevano ai modelli di progettare la disposizione di un ufficio. Nei primi round, i modelli migliori hanno ottenuto 100 e 92, e tutti gli uffici corretti avevano lo stesso aspetto. Un benchmark in cui i modelli migliori raggiungono il massimo non può mostrare i progressi, e uno in cui le risposte si assomigliano non può mostrare la qualità. Per questo la v3 richiede una scultura la cui qualità sia visibile a colpo d'occhio.
Posso provare la consegna?
Sì. La consegna completa è pubblica e disponibile come testo semplice. Incollala in un qualsiasi modello e confronta la sua risposta con il modello di riferimento.
Cite this benchmark
- Title
- VibeiDE Robot scene v1: weekly Claude and GPT model tracking
- URL
https://vibeide.dev/benchmark/- Latest week
- 2026-W47, run
- Publisher
- Crowie s.r.o.
- Method
- Each model answers the same frozen brief once at medium reasoning effort, with no tools. A reply with no usable boxes is asked once more, with a 2-point penalty. Volume overlap against the target, weighted by color accuracy, from 0 to 100.
- Licence
- Benchmark data and charts are licensed under CC BY 4.0. Please credit 'VibeiDE benchmark' with a link to https://vibeide.dev/benchmark/.
Suggested citationCrowie s.r.o. (2026). VibeiDE Robot scene v1: weekly Claude and GPT model tracking, week 2026-W47. https://vibeide.dev/benchmark/#2026-w47